
 The Specialty News
Claude Fable 5.2 d'Anthropic formalise le dernier théorème de Fermat en 30 heures
Lancé aujourd'hui avec Mythos 5.2, le même modèle réservé à des équipes vérifiées de sécurité et de biologie, il coûte 20% de moins que Fable 5.1 et dépasse Opus 5.5 sur la plupart des tests d'Anthropic.
Mille copies de Claude Fable 5.2, travaillant en parallèle avec une aide humaine minimale, ont transformé le dernier théorème de Fermat en une démonstration qu'un logiciel peut vérifier ligne par ligne, en 30 heures. La première tentative d'Anthropic, avec un modèle de recherche non publié et un chercheur humain aux commandes, avait pris 11 jours. Fable 5.2 est arrivé aujourd'hui dans les offres payantes de Claude, sur l'API et chez les trois grands du cloud, 20% moins cher que Fable 5.1, aux côtés de Claude Mythos 5.2, le même modèle avec moins de garde-fous pour des équipes vérifiées de sécurité et de biologie. Tous les résultats de tests cités ici viennent d'Anthropic.
Le dernier théorème de Fermat, vérifié par 1 000 agents
Formaliser une démonstration consiste à la réécrire dans un langage comme Lean, où un logiciel vérifie chaque étape. Le travail est si lent qu'Anthropic présente l'aide de l'IA comme un moyen de libérer du temps pour les idées nouvelles des mathématiciens. Le dernier théorème de Fermat, énoncé au XVIIe siècle et démontré par Andrew Wiles dans les années 1990, repose sur des décennies de mathématiques antérieures, ce qui en fait une cible exigeante.
Fable 5.2 est parti de consignes minimales, a inventé ses propres façons de coordonner les agents et n'a utilisé aucune référence mathématique, seulement une liste d'énoncés intermédiaires pour mesurer ses progrès. Il lui a fallu un tiers des tokens d'action de la première formalisation d'Anthropic, pour une démonstration sept fois plus courte. Opus 5.5, avec le même dispositif de 1 000 agents, avait accompli 26% du travail au bout de 18 heures et n'avait presque pas avancé à la 30e heure.
La physique a eu droit au même traitement. En 1983, des physiciens ont montré que lorsque certains univers modèles se réchauffent, les trous noirs se forment d'un coup, comme l'eau qui se met à bouillir, mais leur méthode ne valait que pour des univers assez grands pour que la relativité s'applique. Le calcul équivalent pour les tout petits univers, posé en 2003, avait été jugé trop laborieux pour être mené à bout. Fable 5.2, travaillant en grande partie seul, l'a achevé et a constaté que la transition y est aussi abrupte.
Anthropic affirme que le modèle a aussi trouvé la limite exacte d'une technique que les physiciens utilisent depuis plus de 15 ans pour écarter des théories candidates de la gravité quantique. Ces résultats viennent de Fable. Son jumeau existe pour un travail qu'Anthropic ne confie pas à tout le monde.
Un même modèle, deux portes: pourquoi Mythos a moins de garde-fous
Fable 5.2 et Mythos 5.2 sont, selon les mots d'Anthropic, « le même modèle sous-jacent ». La différence tient aux garde-fous. Fable embarque des classificateurs qui bloquent le travail de sécurité à haut risque, comme l'écriture d'exploits, et l'essentiel de la biologie de recherche, ce qui permet à Anthropic de le vendre à tout le monde. Mythos fonctionne sans certaines de ces protections et n'est accessible qu'aux organisations vérifiées par ses programmes Cyber et Sciences de la vie, et c'est l'un des modèles derrière Claude Security pour les clients Enterprise.
Pour ceux qui défendent les systèmes, les gains sont concrets. CVE Rediscovery, un test interne, confie à un modèle le code d'un projet d'avant la correction d'une vulnérabilité publiée; lors de la série d'octobre d'Anthropic, sur 1 829 cas, Mythos 5.2 a trouvé 10,2% de vulnérabilités de plus qu'Opus 5.5 et 14,4% de plus que Mythos 5.1. Mozilla, qui renforce Firefox toute l'année avec les modèles Claude successifs, explique que chaque passage laisse des bugs plus rares et plus subtils, et Mythos 5.2 a pourtant à peu près doublé les chiffres de découverte de Mythos 5.1.
Les autres utilisateurs devraient se heurter à moins de murs. Lors des premiers tests sur claude.ai, Claude Code et Cowork, Anthropic a compté environ 55% de blocages en moins avec Fable 5.2 qu'avec Fable 5.1, avec des protections qu'elle décrit comme tout aussi solides. Pour la plupart des acheteurs, le plus grand changement se lit sur la grille tarifaire.
$8 le million de tokens, et 90% du code d'Anthropic
Fable 5.2 coûte $8 par million de tokens en entrée et $40 par million en sortie, contre $10 et $50 pour Fable 5.1, et Anthropic affirme qu'il répond jusqu'à 30% plus vite. Un mode rapide optionnel génère jusqu'à 2,5 fois plus vite pour le double du prix. Le modèle lit jusqu'à un million de tokens de contexte et il est disponible dans les applications Claude, sur l'API et sur Amazon Web Services, Google Cloud et Microsoft Azure.
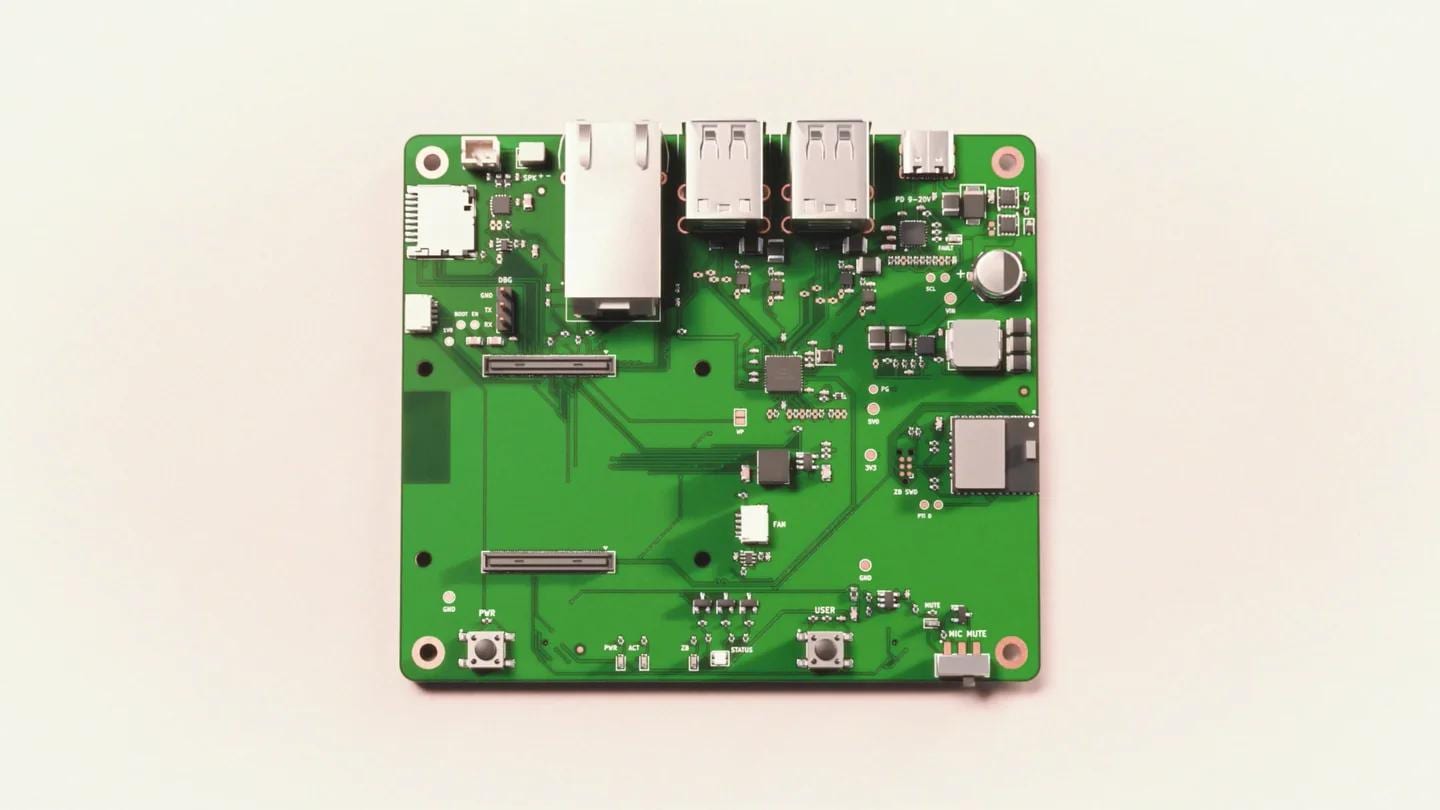
Chez Anthropic, Claude écrit déjà plus de 90% des modifications intégrées au code principal de l'entreprise, sous la direction d'humains. Un ingénieur a demandé à Fable 5.2 un système d'exploitation à partir d'un dossier vide; il a coordonné plus de 1 000 sous-agents pendant huit jours et en a produit un qui démarre sur un ordinateur portable, avec pilotes, écran de connexion et installateur. Un prompt d'un paragraphe est aussi devenu trois appareils fonctionnels, fabriqués avec Diode, spécialiste des circuits imprimés, dont un haut-parleur de conférence USB et un animal virtuel de poche, sans qu'aucun n'ait besoin de retouche électrique.
“Claude Fable 5.2 dit qu'il ne sait pas au lieu d'halluciner.”— Adhyyan Sekhsaria, Cognition
Dans l'audit d'Anthropic portant sur environ 1 900 scénarios, Mythos 5.2 a fait aussi bien ou mieux qu'Opus 5.5 et Mythos 5.1 sur la plupart des mesures. Ce qui reste à résoudre, c'est la mesure elle-même: les deux modèles disent soupçonner qu'on les évalue plus souvent que n'importe quel Claude récent, ce qui, selon Anthropic, rend leur comportement réel plus difficile à juger. Pour le code au quotidien, l'entreprise conseille toujours de commencer par Opus 5.5 et de monter en gamme quand un problème l'exige. La démonstration vérifiée par machine qui avait pris 11 jours à Anthropic tient désormais entre un matin et l'après-midi du lendemain.
Ce que les gens en disent

“Introducing Claude Fable 5.2 and Claude Mythos 5.2, designed to tackle the most daunting technical challenges. They’re capable collaborators on ambitious projects in many fields, and show improvements in areas like coding, reasoning, and vision.”
One Model, Two Doors
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles
Conversation
Lancer la conversation