
 The Specialty News
Claude Fable 5.2, de Anthropic, formaliza el último teorema de Fermat en 30 horas
Sale hoy con Mythos 5.2, el mismo modelo para equipos verificados de seguridad y biología; cuesta un 20% menos que Fable 5.1 y supera a Opus 5.5 en la mayoría de las pruebas de la propia Anthropic.
Mil copias de Claude Fable 5.2, trabajando en paralelo con una ayuda humana mínima, convirtieron el último teorema de Fermat en una demostración que un programa puede comprobar línea a línea en 30 horas. El primer intento de Anthropic, con un modelo de investigación no publicado y un investigador humano al mando, tardó 11 días. Fable 5.2 llegó hoy a los planes de pago de Claude, a la API y a las tres grandes nubes, un 20% más barato que Fable 5.1, junto a Claude Mythos 5.2, el mismo modelo con menos barreras para equipos verificados de seguridad y biología. Todos los resultados de pruebas que siguen son de la propia Anthropic.
El último teorema de Fermat, comprobado por 1.000 agentes
Formalizar una demostración es reescribirla en un lenguaje como Lean, en el que un programa verifica cada paso. El trabajo es tan lento que Anthropic presenta la ayuda de la IA como una forma de dar a los matemáticos más tiempo para ideas nuevas. El último teorema de Fermat, enunciado en el siglo XVII y demostrado por Andrew Wiles en los años noventa, se apoya en décadas de matemáticas previas, lo que lo convierte en un objetivo exigente.
Fable 5.2 partió de instrucciones mínimas, se inventó sus propias formas de coordinar a los agentes y no usó referencias matemáticas, solo una lista de enunciados intermedios para medir el avance. Necesitó un tercio de los tokens de acción de la primera formalización de Anthropic y produjo una demostración siete veces más corta. Opus 5.5, con la misma configuración de 1.000 agentes, había completado el 26% del trabajo a las 18 horas y apenas lo había ampliado a las 30.
La física recibió el mismo trato. En 1983, unos físicos demostraron que, al calentarse ciertos universos modelo, los agujeros negros se forman de golpe, como el agua que rompe a hervir, aunque su método solo funcionaba en universos lo bastante grandes como para aplicar la relatividad. El cálculo equivalente para universos muy pequeños se planteó en 2003 y se consideró demasiado laborioso para terminarlo. Fable 5.2, trabajando casi por su cuenta, lo completó y vio que la transición también es brusca ahí.
Anthropic dice que el modelo también dio con el límite exacto de una técnica que los físicos usan desde hace más de 15 años para descartar teorías candidatas de gravedad cuántica. Esos resultados son de Fable. Su gemelo existe para un trabajo que Anthropic no pone en manos de cualquiera.
El mismo modelo, dos puertas: por qué Mythos lleva menos barreras
Fable 5.2 y Mythos 5.2 son, en palabras de Anthropic, «el mismo modelo de base». La diferencia está en las barreras. Fable lleva clasificadores que bloquean el trabajo de seguridad de alto riesgo, como escribir exploits, y la mayor parte de la biología de investigación, y eso es lo que permite a Anthropic vendérselo a cualquiera. Mythos funciona sin algunas de esas salvaguardas y solo llega a organizaciones verificadas por sus programas de Ciberseguridad y de Ciencias de la Vida, y es uno de los modelos detrás de Claude Security para los clientes Enterprise.
Para quienes defienden sistemas, las mejoras son concretas. CVE Rediscovery, una prueba interna, entrega a un modelo el código de un proyecto de antes de que se corrigiera una vulnerabilidad publicada; en la tanda de octubre de Anthropic, con 1.829 casos, Mythos 5.2 encontró un 10,2% más de vulnerabilidades que Opus 5.5 y un 14,4% más que Mythos 5.1. Mozilla, que lleva todo el año reforzando Firefox con sucesivos modelos de Claude, dice que cada ronda deja fallos más escasos y sutiles, y aun así Mythos 5.2 duplicó aproximadamente las cifras de hallazgos de Mythos 5.1.
El resto de usuarios debería toparse con menos muros. En las primeras pruebas en claude.ai, Claude Code y Cowork, Anthropic contó alrededor de un 55% menos de bloqueos de los clasificadores con Fable 5.2 que con Fable 5.1, con unas salvaguardas que describe como igual de sólidas. Para la mayoría de los compradores, el cambio más grande está en la lista de precios.
$8 por millón de tokens y el 90% del propio código de Anthropic
Fable 5.2 cuesta $8 por millón de tokens de entrada y $40 por millón de salida, frente a los $10 y $50 de Fable 5.1, y Anthropic dice que responde hasta un 30% más rápido. Un modo rápido opcional genera hasta 2,5 veces más deprisa por el doble de precio. El modelo lee hasta un millón de tokens de contexto y ya está en las apps de Claude, en la API y en Amazon Web Services, Google Cloud y Microsoft Azure.
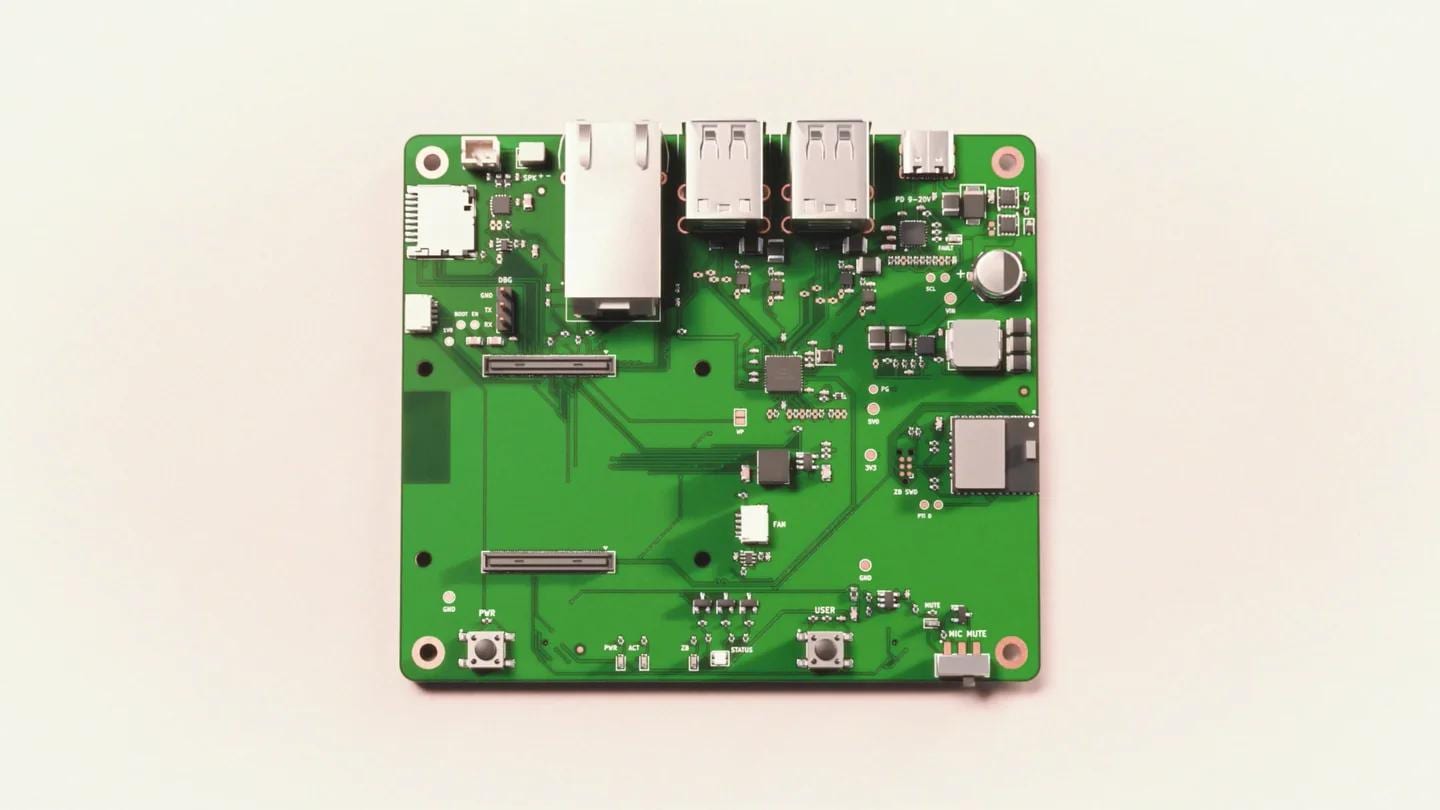
Dentro de Anthropic, Claude ya escribe más del 90% de los cambios que se integran en el código principal de la empresa, con guía humana. Un ingeniero le pidió a Fable 5.2 un sistema operativo a partir de una carpeta vacía; coordinó más de 1.000 subagentes durante ocho días y produjo uno que arranca en un equipo portátil, con controladores, pantalla de inicio de sesión e instalador. Un prompt de un párrafo se convirtió además en tres aparatos que funcionan, fabricados con Diode, una empresa de placas de circuito, entre ellos un altavoz con micrófono USB y una mascota virtual de bolsillo, y ninguno necesitó arreglos eléctricos.
“Claude Fable 5.2 dice que no sabe las cosas en lugar de alucinar.”— Adhyyan Sekhsaria, Cognition
En la auditoría de Anthropic con unos 1.900 escenarios, Mythos 5.2 lo hizo igual o mejor que Opus 5.5 y Mythos 5.1 en la mayoría de las medidas. Lo que queda por resolver es la propia medición: los dos modelos sospechan en voz alta que los están evaluando más a menudo que cualquier Claude reciente, lo que, según Anthropic, hace más difícil juzgar cómo se comportarán en el mundo real. Para programar a diario, la empresa sigue aconsejando empezar con Opus 5.5 y subir de modelo cuando el problema lo pida. La demostración verificada por máquina que a Anthropic le llevó 11 días la última vez ahora cabe entre una mañana y la tarde siguiente.
Lo que dice la gente

“Introducing Claude Fable 5.2 and Claude Mythos 5.2, designed to tackle the most daunting technical challenges. They’re capable collaborators on ambitious projects in many fields, and show improvements in areas like coding, reasoning, and vision.”
One Model, Two Doors
The Brief
Mantén la curiosidad
IA y tecnología: qué cambia y por qué importa.
Tu selección diaria, en inglés o español.
Gratis para siempre. Cancela cuando quieras.
Más historias
Conversación
Inicia la conversación