
 The Specialty News
Nvidia ouvre ses racks aux puces d'IA coréennes, à commencer par Rebellions
Les GPU de Nvidia liront chaque requête et les puces R200 de Rebellions, conçues en Corée, écriront la réponse, dans des racks de SK Telecom prêts pour 2028.
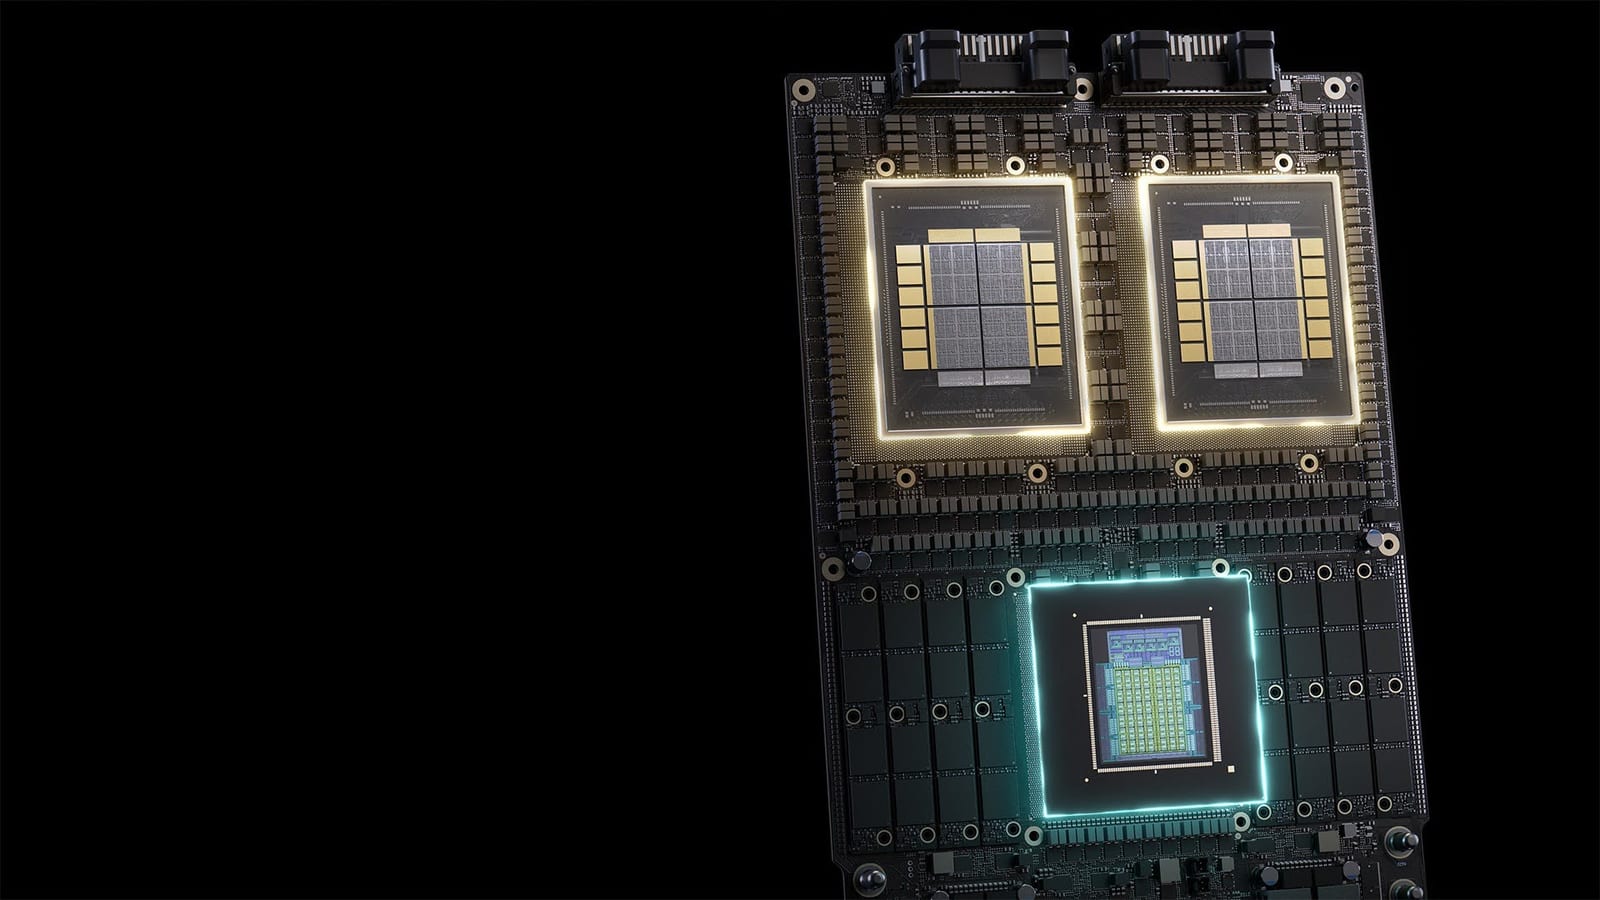
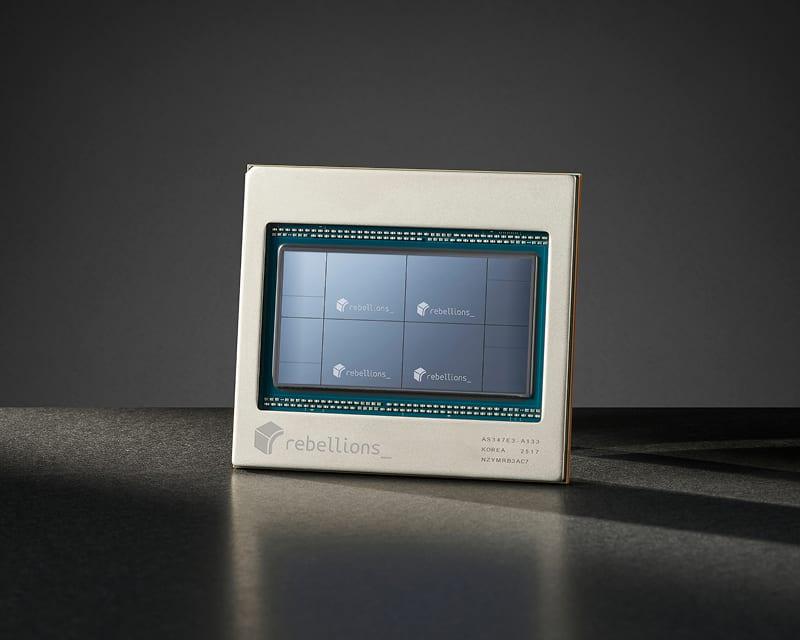
À partir de 2028, certaines réponses des modèles d'IA coréens seront réparties entre deux puces conçues dans deux pays. Les GPU de Nvidia liront la question et un processeur R200, conçu par la start-up séoulienne Rebellions, rédigera la réponse, dans le même rack du centre de données de SK Telecom. L'accord, annoncé le 8 novembre et soutenu par le ministère coréen des Sciences, fait de Rebellions la première entreprise coréenne de puces d'IA à se brancher sur NVLink Fusion, la technologie que Nvidia a ouverte en 2025 pour que des processeurs tiers rejoignent ses racks.
Une réponse, deux types de puces
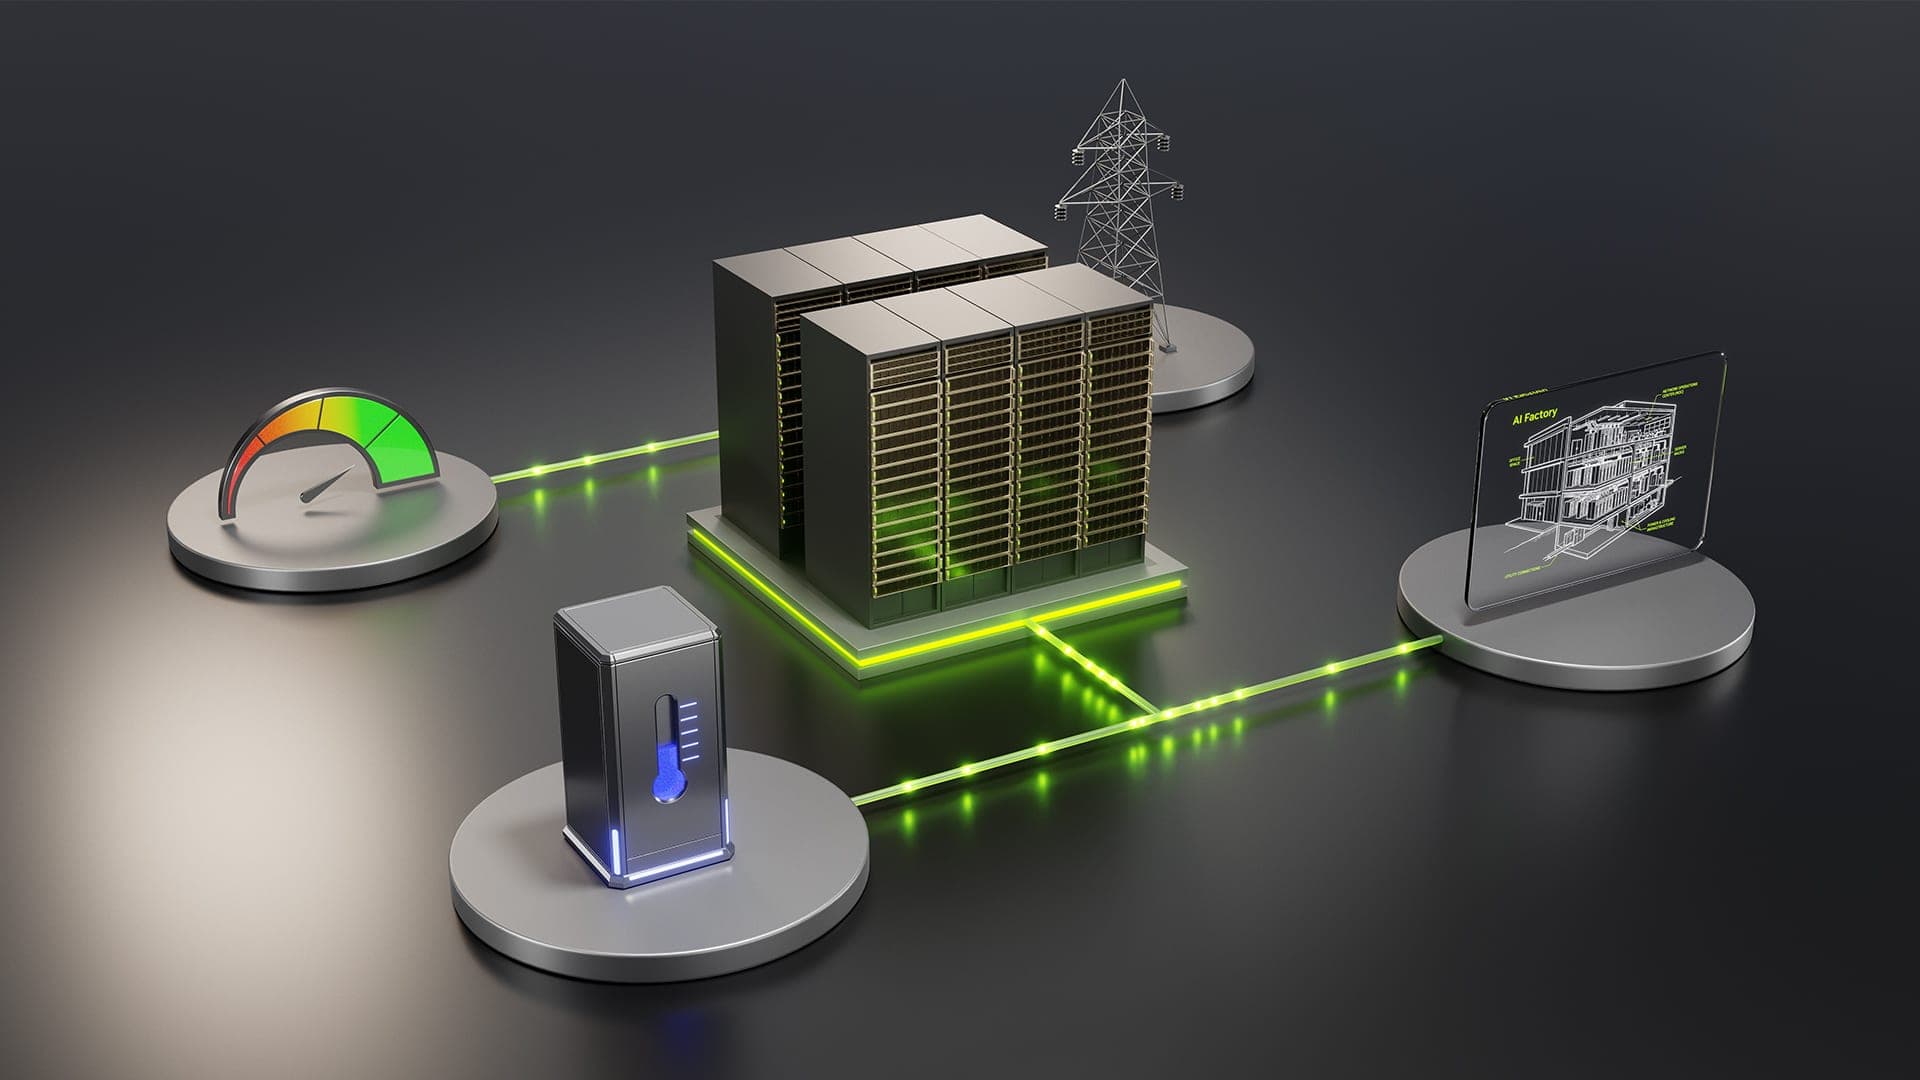
Aux termes de l'accord, Rebellions reliera ses unités de traitement neuronal Rebel R200 de nouvelle génération à la plateforme de Nvidia grâce à NVLink Fusion et construira ses systèmes sur la conception de rack MGX de Nvidia. NVLink est la liaison à haut débit qui permet à des dizaines de GPU Nvidia de se comporter comme un seul processeur géant. Fusion est la version que Nvidia a ouverte aux puces sur mesure d'autres entreprises, et MGX offre à Rebellions une chaîne d'approvisionnement toute prête de fabricants de serveurs et de fournisseurs de composants.
L'astuce tient au partage du travail. Les entreprises prévoient ce que les ingénieurs appellent l'inférence désagrégée : les GPU de Nvidia se chargent du prefill et les NPU de Rebellions du decode. Le prefill, c'est le modèle qui lit toute votre requête d'un coup, une rafale de calcul parallèle pour laquelle les GPU sont conçus. Le decode, c'est le modèle qui écrit sa réponse jeton par jeton, une tâche longue et régulière dont la vitesse dépend surtout du transfert des données depuis la mémoire, et où une puce conçue uniquement pour l'inférence peut économiser de l'énergie.
Rebellions affirme que le R200 est optimisé pour une inférence à faible latence et économe en énergie sur des modèles de pointe, y compris des modèles à mélange d'experts de plusieurs milliers de milliards de paramètres. Les premiers systèmes devraient être prêts à être déployés en 2028. Pourquoi Nvidia ferait-il de la place dans son propre rack ? La réponse commence par une promesse faite en Corée un an plus tôt.
D'un quart de million de GPU au silicium coréen
Au sommet de l'APEC à Gyeongju, en octobre 2025, Nvidia a annoncé un déploiement dans l'administration et l'industrie coréennes : plus de 50 000 de ses GPU pour le programme d'IA souveraine du gouvernement, plus de 50 000 pour Samsung et autant pour SK Group, 50 000 pour Hyundai Motor Group et plus de 60 000 pour Naver Cloud.
Cet accord a apporté à la Corée de la puissance de calcul. Celui-ci ouvre la porte à ses concepteurs de puces. Parallèlement à l'accord avec Rebellions, Nvidia et le ministère des Sciences et des TIC ont annoncé élargir leur collaboration des puces et des centres de données aux talents, aux start-up, aux modèles, aux agents et à la sécurité. Le programme pose les bases pour que d'autres entreprises coréennes de NPU et de XPU explorent NVLink Fusion, et ajoute des formations et certifications Nvidia, des hackathons et des séminaires techniques. Dans le cadre de l'initiative coréenne AI for All, Nvidia travaillera aussi avec trois consortiums sélectionnés et quatre grands créateurs coréens de modèles de fondation, grâce à son logiciel Dynamo pour optimiser l'inférence et la faire passer à l'échelle.
Jensen Huang a résumé la logique en une phrase :
“L'IA souveraine donne aux nations le pouvoir de transformer leur langue, leur culture et leur savoir-faire en intelligence.”— Jensen Huang
Rebellions est un premier partenaire tout trouvé. Sa puce phare, la Rebel100, est déjà déployée commercialement auprès d'entreprises et d'administrations, et ses investisseurs comptent Aramco, Arm, Samsung, SK Hynix et SK Telecom elle-même. Alors, que gagne la Corée une fois ces racks en service ?
Un modèle coréen sur du silicium coréen, d'ici 2028
SK Telecom prévoit de relier les nouveaux systèmes à ses propres modèles de fondation, dont A.X K2, et aux services publics créés dans le cadre du projet gouvernemental AI for All. Jung Jai-hun, PDG de SK Telecom, a déclaré que la collaboration « valide le potentiel d'une infrastructure d'IA souveraine de nouvelle génération en combinant la technologie mondiale d'infrastructure d'IA avec des semi-conducteurs d'IA coréens ».
Pour Rebellions, l'enjeu est la portée. Ses puces trouvent un chemin vers des racks que les centres de données savent déjà alimenter, refroidir et acheter. Son cofondateur et PDG, Sunghyun Park, a qualifié l'annonce de « tournant » et promis « une inférence à faible latence et économe en énergie pour les modèles de pointe, à grande échelle ».
Le gouvernement y voit une première étape. Bae Kyung-hoon, vice-Premier ministre et ministre des Sciences de Corée, a déclaré que l'accord « permet aux NPU développées en Corée d'entrer sur le marché des infrastructures de calcul aux côtés de NVIDIA », et que Séoul poussera le partenariat plus loin, « notamment dans l'IA physique et la sécurisation de l'approvisionnement en GPU ».
Reste à concrétiser la puce elle-même : le R200 est encore en développement et Rebellions n'a pas publié ses performances. S'il tient ses promesses, une question posée en coréen à un service public coréen recevra une réponse écrite en partie par un processeur coréen. Le prochain pays qui voudra ses propres puces dans les racks de Nvidia dispose désormais d'un modèle, et il a été écrit à Séoul.
Nvidia Reads, Korea Writes
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles
Conversation
Lancer la conversation