
 The Specialty News
AMD lance son EPYC Venice à 256 cœurs, avec jusqu'à 73 728 threads par baie
Le haut de gamme EPYC 9996 est affiché à 14 904 dollars et fait 68% de mieux que son prédécesseur dans les résultats SPEC publiés, et les serveurs qui l'embarquent sont déjà livrés.
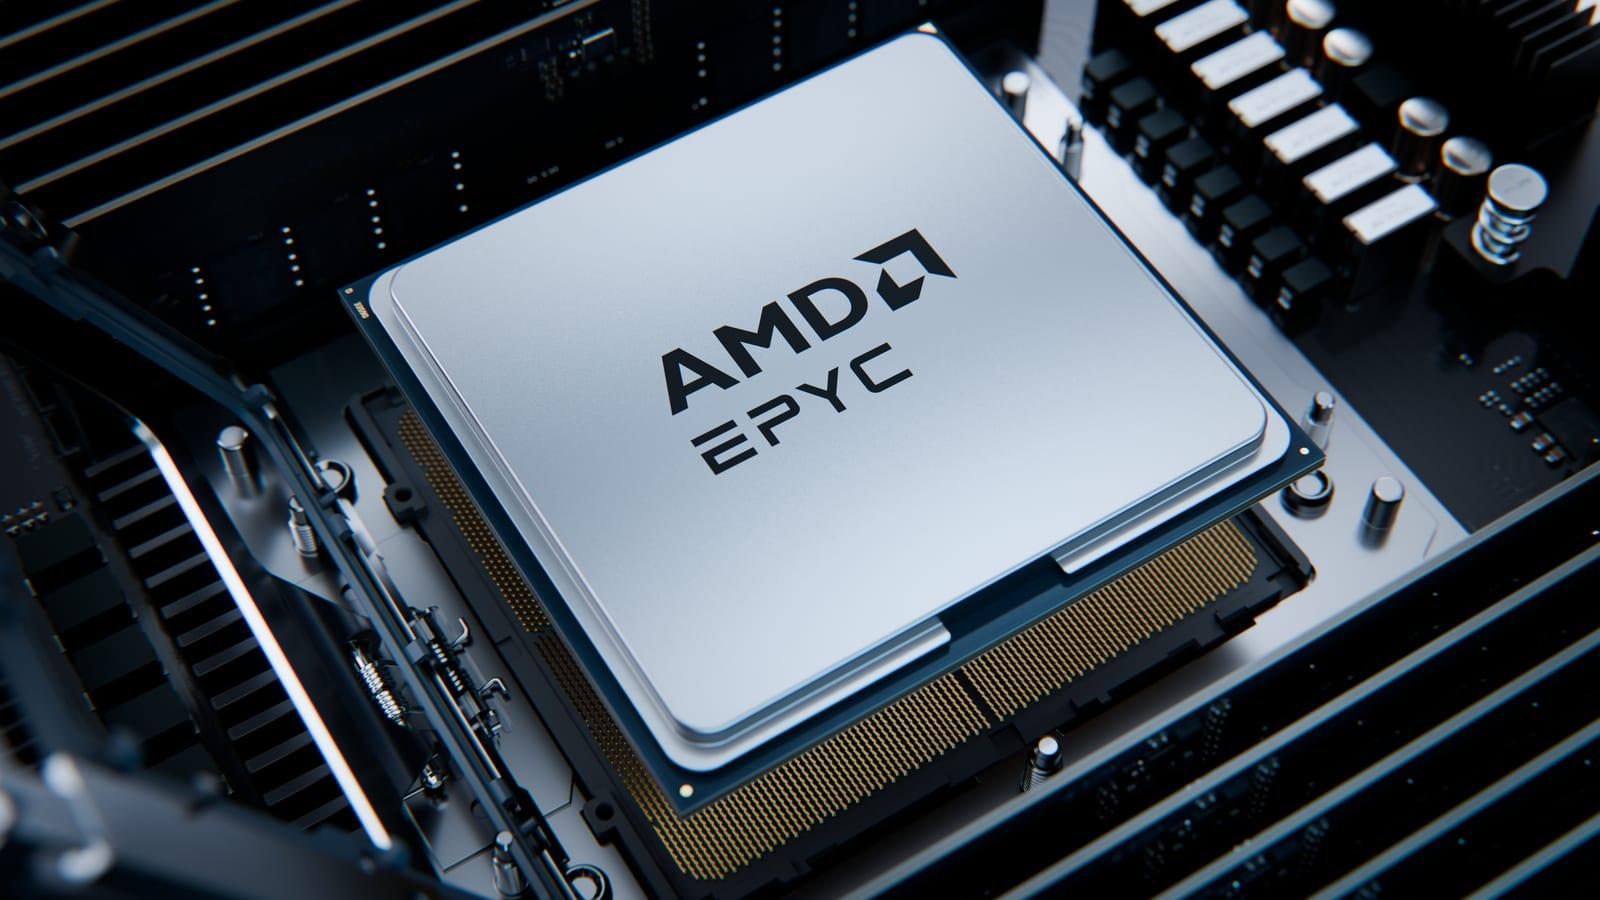
Un seul AMD EPYC 9996 exécute 512 threads à la fois, et depuis mardi les serveurs construits autour de lui sont livrés. AMD a annoncé le 10 novembre la disponibilité générale de ses processeurs pour serveurs EPYC de sixième génération, nom de code Venice; Meta valide la plateforme en tant que client principal et Microsoft Azure propose déjà ses premières instances en préversion. L'argument vise le métier le plus récent du centre de données: héberger des agents d'IA qui écrivent du code, appellent des outils et interrogent des bases de données, un travail qui revient aux CPU plutôt qu'aux GPU.
256 cœurs pour 14 904 dollars
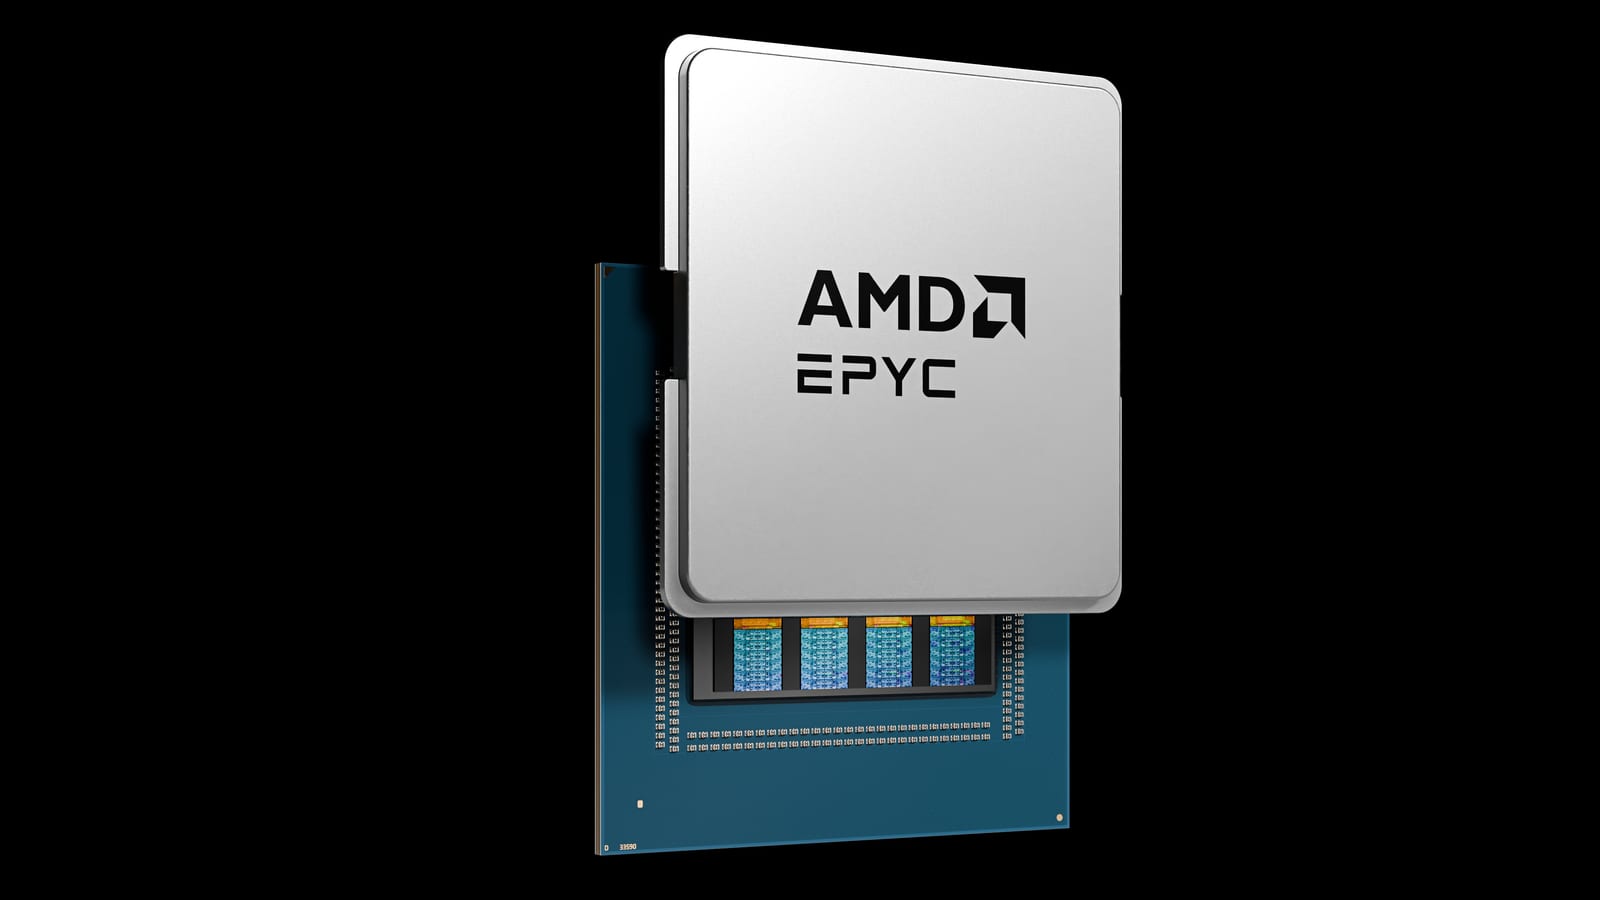
L'EPYC 9996 coiffe une famille bâtie sur l'architecture Zen 6 d'AMD. Chaque puce compte 256 cœurs, consomme 600 watts selon la nouvelle mesure Default CPU Power d'AMD et s'affiche à 14 904 dollars par lots de 1 000 unités. AMD avait annoncé en avril 2025 que Venice était le premier produit de calcul haute performance du secteur conçu et produit avec le procédé 2 nanomètres de TSMC, et il arrive l'année promise par AMD.
Sur SPECrate2017, le test de référence du secteur pour le débit en calcul entier, un serveur à deux 9996 a obtenu 5 470 points dans des résultats publiés sur spec.org. Un serveur équipé de deux puces de l'ancien haut de gamme, l'EPYC 9965, a obtenu 3 260. Cela fait 68% de débit en plus en une seule génération, pour environ 24% de plus par puce.
Les comparaisons d'AMD vont plus loin: jusqu'à 2,2 fois les performances et deux fois les performances par dollar d'un serveur équipé du Xeon 6980P d'Intel, et jusqu'à 3,7 fois celles d'un système Nvidia Vera. Le chiffre de Vera est une estimation d'AMD fondée sur des tests publics de Phoronix, car Nvidia n'a publié aucun score.
Ces comparaisons comptent surtout pour un client d'un genre plus récent: celui qui fait tourner des agents d'IA.
Pourquoi les agents d'IA vivent sur les CPU
Un agent d'IA passe une grande partie de sa vie de travail loin du GPU. Il exécute du code dans un bac à sable, ouvre des fichiers, appelle des API et attend des bases de données, et chacune de ces tâches réclame un thread de CPU. AMD répartit l'infrastructure des agents en trois rôles pour le CPU: les services généralistes, les nœuds hôtes qui alimentent les GPU et les serveurs denses qui font tourner les bacs à sable des agents. Venice existe en une version pour chacun.
“L'IA élargit considérablement le rôle du CPU à tous les niveaux du centre de données.”— Dan McNamara, AMD
Pour les bacs à sable, AMD revendique environ 3,3 fois plus d'agents par watt de CPU que Nvidia Vera et 2,5 fois plus que le Xeon 6980P d'Intel. La méthode compte: AMD utilise les threads disponibles comme indicateur du nombre d'agents, si bien que le chiffre mesure la marge de travail en parallèle qu'une puce offre par watt, pas des agents observés en production.
Pour les nœuds hôtes de GPU, les versions haute fréquence de Venice atteignent 5,3 GHz. Quand une partie des poids d'un modèle de langage est stockée dans la mémoire du système plutôt que sur le GPU, AMD prévoit jusqu'à 1,8 fois le débit de la génération précédente, car le PCIe 6.0 double la largeur du lien entre les deux. Empilez assez de ces puces et l'unité qui compte cesse d'être le serveur.
73 728 threads dans une seule baie
AMD vend désormais Venice à la baie. Sa gamme Helion se décline en trois versions: Helion Liquid, conçue pour s'installer à côté des baies GPU Helios d'AMD dans les grands déploiements d'agents; Helion Air, pour les centres de données encore refroidis par air; et Helion Air Inference, qui réunit l'exécution sur CPU et l'inférence locale sur GPU dans une même armoire.
Selon le calcul d'AMD d'un thread par agent, cela laisse la place à plus de 70 000 bacs à sable d'agents dans une armoire de la hauteur d'un grand réfrigérateur. AMD indique aussi qu'un réglage de gestion de l'énergie permet de loger environ 18% d'agents en plus dans la même baie de 35 kilowatts, en plafonnant la puissance que chaque serveur peut consommer.
Les premiers clients se positionnent. Meta valide les plateformes Venice en tant que client principal avant un déploiement à grande échelle, les instances Azure HDv2 pour le traitement de données d'IA, l'IA agentique et le HPC sont en préversion, et les instances OCI Compute E7 d'Oracle tourneront sur les nouvelles puces. Pour qui fait tourner des agents à grande échelle, plus de threads par watt signifie plus d'agents par bâtiment sans couler de nouveau béton.
Les modèles réfléchissent sur les GPU. Tout ce qu'un agent fait de cette réflexion tourne sur des puces comme Venice.
Venice Adds 68% More Throughput
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles
Conversation
Lancer la conversation