
 The Specialty News
AMD lanza su EPYC Venice de 256 núcleos, con hasta 73.728 hilos por rack
El EPYC 9996, el modelo tope de gama, cuesta 14.904 dólares y logra un 68% más que su predecesor en los resultados SPEC publicados, y los servidores con este chip ya se están enviando.
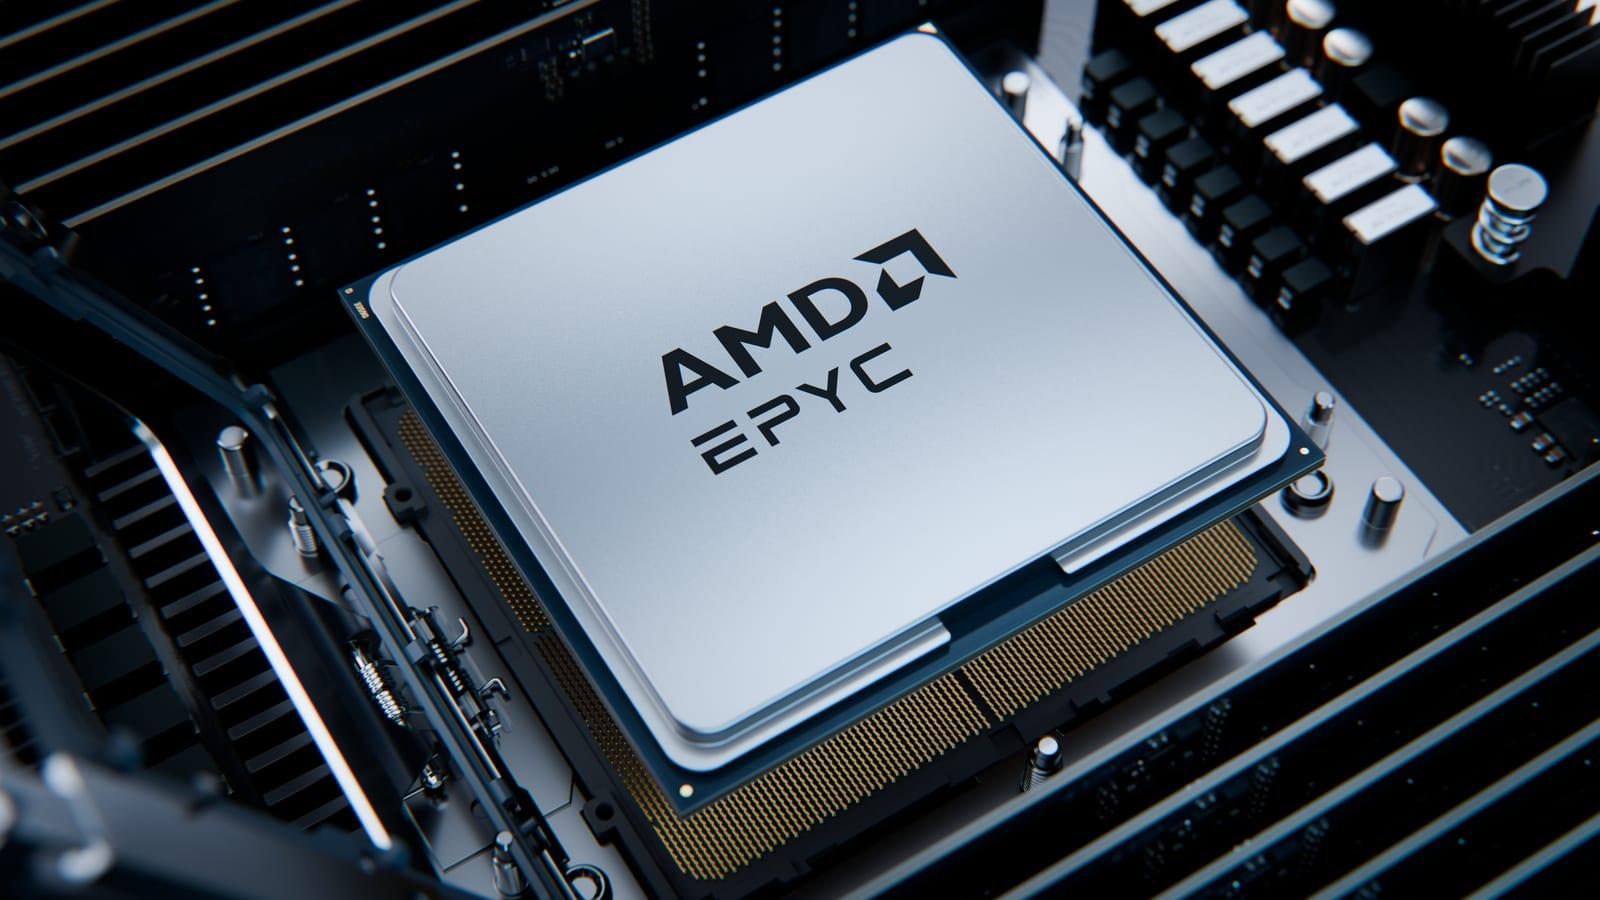
Un solo AMD EPYC 9996 ejecuta 512 hilos a la vez, y desde el martes los servidores construidos a su alrededor se están enviando. AMD anunció el 10 de noviembre la disponibilidad general de sus procesadores para servidores EPYC de sexta generación, con nombre en clave Venice; Meta valida la plataforma como cliente principal y Microsoft Azure ya ofrece sus primeras instancias en versión preliminar. La propuesta apunta al trabajo más nuevo del centro de datos: alojar agentes de IA que escriben código, llaman a herramientas y consultan bases de datos, un trabajo que recae en las CPU y no en las GPU.
256 núcleos por 14.904 dólares
El EPYC 9996 encabeza una familia construida sobre la arquitectura Zen 6 de AMD. Cada chip lleva 256 núcleos, consume 600 vatios según la nueva medida Default CPU Power de AMD y tiene un precio de lista de 14.904 dólares en lotes de 1.000 unidades. AMD dijo en abril de 2025 que Venice era el primer producto de computación de alto rendimiento del sector diseñado y fabricado con el proceso de 2 nanómetros de TSMC, y ha llegado en el año que AMD prometió.
En SPECrate2017, la prueba estándar del sector para el rendimiento con números enteros, un servidor con dos 9996 obtuvo 5.470 puntos en resultados publicados en spec.org. Un servidor con dos chips del anterior tope de gama, el EPYC 9965, obtuvo 3.260. Son un 68% más de rendimiento en una sola generación, por alrededor de un 24% más de dinero por chip.
Las comparaciones propias de AMD van más allá: hasta 2,2 veces el rendimiento y el doble de rendimiento por dólar que un servidor con el Xeon 6980P de Intel, y hasta 3,7 veces el de un sistema Nvidia Vera. La cifra de Vera es una estimación de AMD basada en pruebas públicas de Phoronix, porque Nvidia no ha publicado ningún resultado.
Esas comparaciones importan sobre todo a un tipo de cliente más nuevo: el que ejecuta agentes de IA.
Por qué los agentes de IA viven en las CPU
Un agente de IA pasa gran parte de su vida laboral lejos de la GPU. Ejecuta código en un entorno aislado, abre archivos, llama a API y espera a las bases de datos, y cada una de esas tareas necesita un hilo de CPU. AMD divide la infraestructura de agentes en tres funciones de CPU: servicios de uso general, nodos anfitriones que mantienen abastecidas a las GPU y servidores densos que ejecutan los entornos aislados de los agentes. Venice tiene una versión para cada una.
“La IA está ampliando de forma significativa el papel de la CPU en todas las capas del centro de datos.”— Dan McNamara, AMD
Para los entornos aislados, AMD asegura que ofrece unas 3,3 veces más agentes por vatio de CPU que Nvidia Vera y 2,5 veces más que el Xeon 6980P de Intel. El método importa: AMD cuenta los hilos disponibles como sustituto de los agentes, así que la cifra mide cuánto margen de trabajo en paralelo ofrece un chip por vatio, no agentes observados en producción.
Para los nodos anfitriones de GPU, las versiones de alta frecuencia de Venice llegan a 5,3 GHz. Cuando parte de los pesos de un modelo de lenguaje se guarda en la memoria del sistema en lugar de en la GPU, AMD prevé hasta 1,8 veces la producción de la generación anterior, porque PCIe 6.0 duplica la anchura del enlace entre ambas. Si se apilan suficientes chips como estos, la unidad que importa deja de ser el servidor.
73.728 hilos en un solo rack
AMD ya vende Venice por racks. Su línea Helion tiene tres versiones: Helion Liquid, pensada para colocarse junto a los racks de GPU Helios de AMD en grandes despliegues de agentes; Helion Air, para centros de datos que aún se refrigeran por aire; y Helion Air Inference, que combina la ejecución en CPU y la inferencia local en GPU en un mismo armario.
Según la cuenta de AMD de un hilo por agente, eso deja sitio para más de 70.000 entornos aislados de agentes en un armario de la altura de un frigorífico alto. AMD también dice que un ajuste de gestión de energía permite meter alrededor de un 18% más de agentes en el mismo rack de 35 kilovatios, al limitar la potencia que puede consumir cada servidor.
Los primeros clientes ya se ponen en fila. Meta valida las plataformas Venice como cliente principal antes de desplegarlas a gran escala, las instancias Azure HDv2 para procesamiento de datos de IA, IA agéntica y HPC están en versión preliminar, y las instancias OCI Compute E7 de Oracle funcionarán con los nuevos chips. Para quien ejecuta agentes a gran escala, más hilos por vatio significan más agentes por edificio sin echar hormigón nuevo.
Los modelos piensan en las GPU. Todo lo que un agente hace con ese pensamiento se ejecuta en chips como Venice.
Venice Adds 68% More Throughput
The Brief
Mantén la curiosidad
IA y tecnología: qué cambia y por qué importa.
Tu selección diaria, en inglés o español.
Gratis para siempre. Cancela cuando quieras.
Más historias
Conversación
Inicia la conversación