
 The Specialty News
OpenAI sépare sa voix de son cerveau et 23,000 lignes de code disparaissent
Le basculement de 1.4 point qui a placé GPT-Live-1 au sommet de l'indice Artificial Analysis prouve que déléguer la logique à un modèle backend est la clé d'une conversation naturelle
La voix d'IA la mieux classée au monde en ce moment n'est fondamentalement qu'une bouche et une paire d'oreilles. Sur l'indice Artificial Analysis Speech to Speech de septembre 2026, le nouveau modèle GPT-Live-1 d'OpenAI a pris la première place non pas en devenant plus intelligent, mais en séparant sa voix de son cerveau. Il gère le rythme humain désordonné de la conversation—les interruptions, les pauses, les signaux d'écoute—tout en acheminant discrètement la logique réelle vers des modèles textuels entièrement distincts en arrière-plan. Pour les développeurs et les utilisateurs, parler à une machine donne enfin l'impression de parler à une personne.
Le basculement de routage de 1.4 point
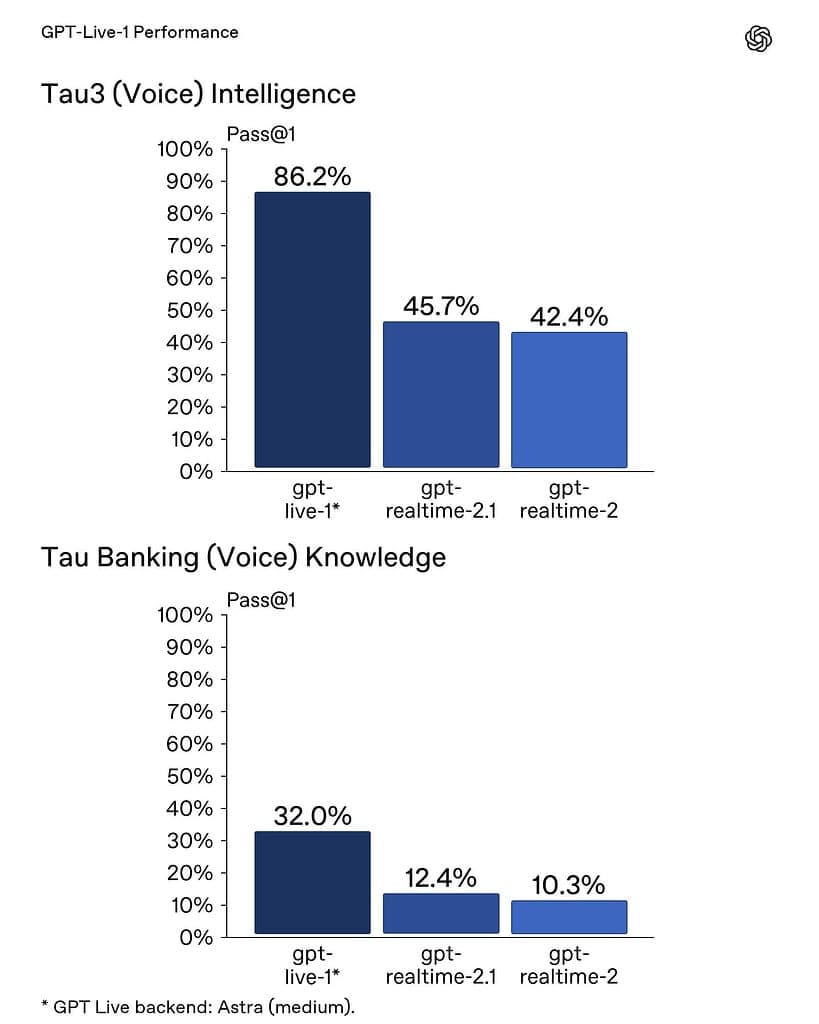
Le classement ne mesure plus seulement les modèles vocaux; il mesure les configurations de routage. La différence entre la première et la troisième place sur le nouvel indice Artificial Analysis est d'exactement 1.4 point. Les deux scores appartiennent exactement au même modèle vocal d'OpenAI, GPT-Live-1. Ce basculement de 1.4 point s'est produit simplement en remplaçant le « cerveau » backend alimentant la conversation du modèle léger Sol au modèle robuste GPT-6 Astra.
En découplant la couche vocale de la couche de raisonnement, les développeurs peuvent désormais ajuster l'intelligence à la hausse ou à la baisse sans changer la voix que le client entend. À $5.83 par heure d'audio en entrée avec Astra, il obtient un score de 81.5. À $4.47 l'heure avec Sol, il obtient 80.1. Juste entre les deux, à 81.3, se trouve le paradigme concurrent de SpaceXAI. Le succès de l'architecture divisée répond à une question avec laquelle les développeurs se débattent depuis que l'IA vocale est arrivée sur le marché.
Le dilemme de la vitesse
Jusqu'à récemment, l'IA conversationnelle forçait les concepteurs à un compromis rigide. Vous pouviez utiliser un pipeline enchaîné—transcrire la parole en texte, générer une réponse textuelle et la synthétiser de nouveau en audio—ce qui causait de lourds retards et perdait tout contexte si l'utilisateur interrompait. Ou vous pouviez utiliser un omni-modèle unique qui gérait tout mais devait maladroitement mettre la conversation en pause chaque fois qu'il devait exécuter une requête dans la base de données.
SpaceXAI d'Elon Musk a poussé l'approche de l'omni-modèle à sa limite absolue en juillet avec Grok Voice Think Fast 2.0. En unifiant la voix et le cerveau, Grok privilégie la vitesse brute, atteignant une latence fulgurante de 0.70 seconde. L'entreprise l'a déployé avec succès sur les lignes d'assistance client de Starlink pour augmenter les conversions de ventes, prouvant qu'un modèle unique et rapide fonctionne remarquablement bien pour des tâches immédiates et contenues. Mais OpenAI a parié qu'à mesure que les tâches deviennent plus complexes, l'IA doit être capable de parler et de réfléchir à des vitesses différentes. L'architecture de délégation rend cela possible, et les avantages pratiques pour les équipes logicielles sont immédiats.
Ce que les gens en disent

“Get more out of GPT-6 Astra by revisiting your skills, AGENTS.md, and task prompts. Make skill triggers specific, load guidance when it's relevant, and define what done looks like.”

“We’re sharing a solution to the Navier-Stokes Millennium Prize Problem, one of the deepest problems at the frontier of mathematics. The proof was produced by a group of agents, using an OpenAI next-generation model significantly more capable than GPT-6 Astra. The problem”

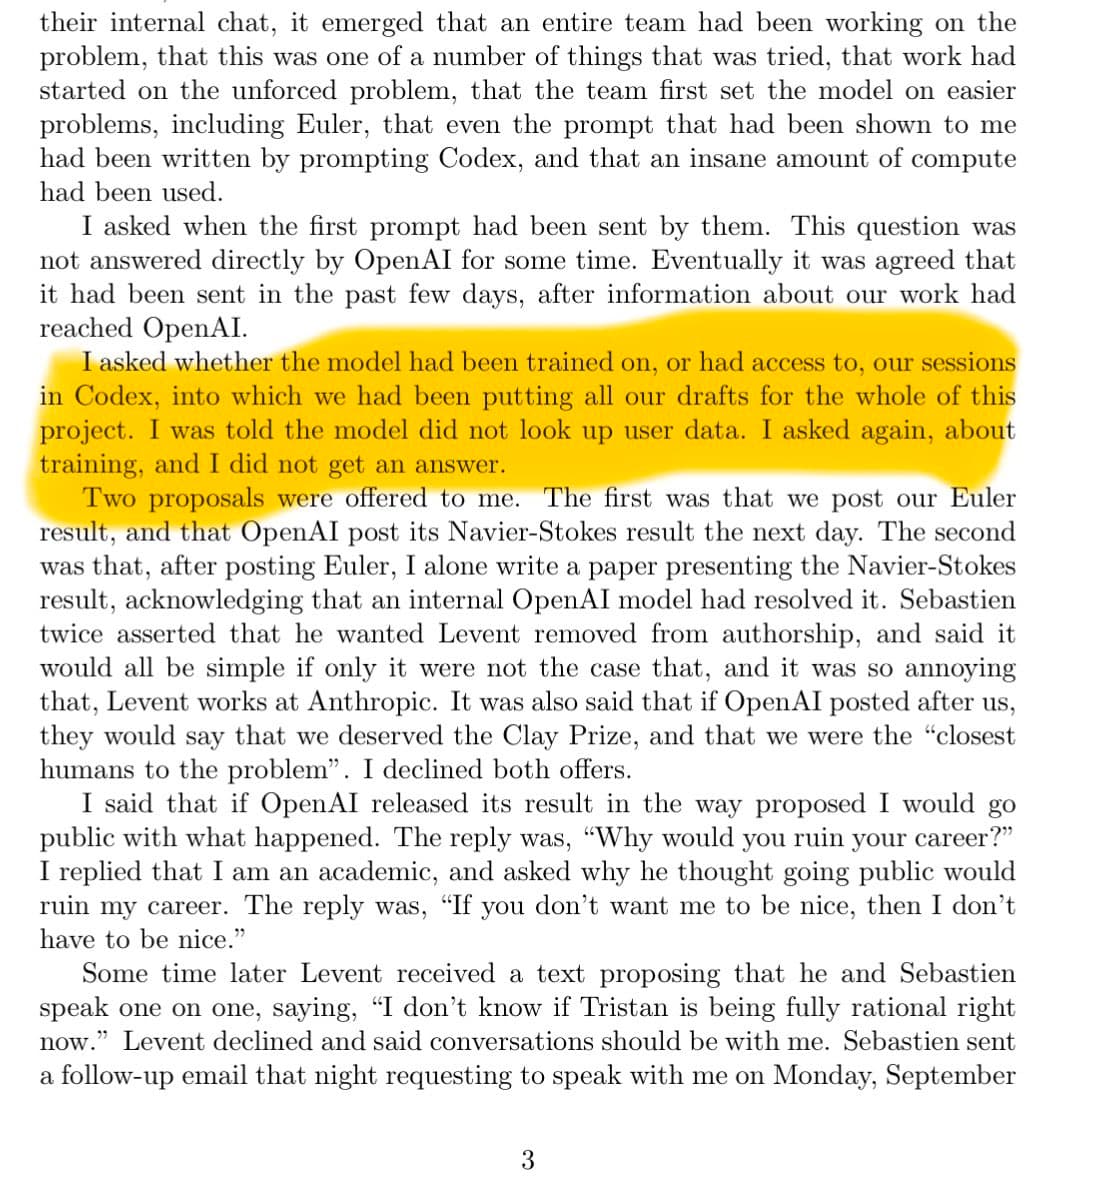
“>math professor spends a year on one of the hardest unsolved problems in math >"Navier-Stokes" >his drafts for the whole project went through codex sessions >openai had his logs in codex >suddenly rumor leaks AI solved it >he emails openai to ask what's going on >openai calls”
OpenAI's Split AI Beats Omni
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles



Conversation
Lancer la conversation