
 The Specialty News
OpenAI separa su voz de su cerebro y desaparecen 23.000 líneas de código
El giro de 1,4 puntos que colocó a GPT-Live-1 en la cima del índice de Artificial Analysis demuestra que delegar la lógica a un modelo backend es la clave para una conversación natural
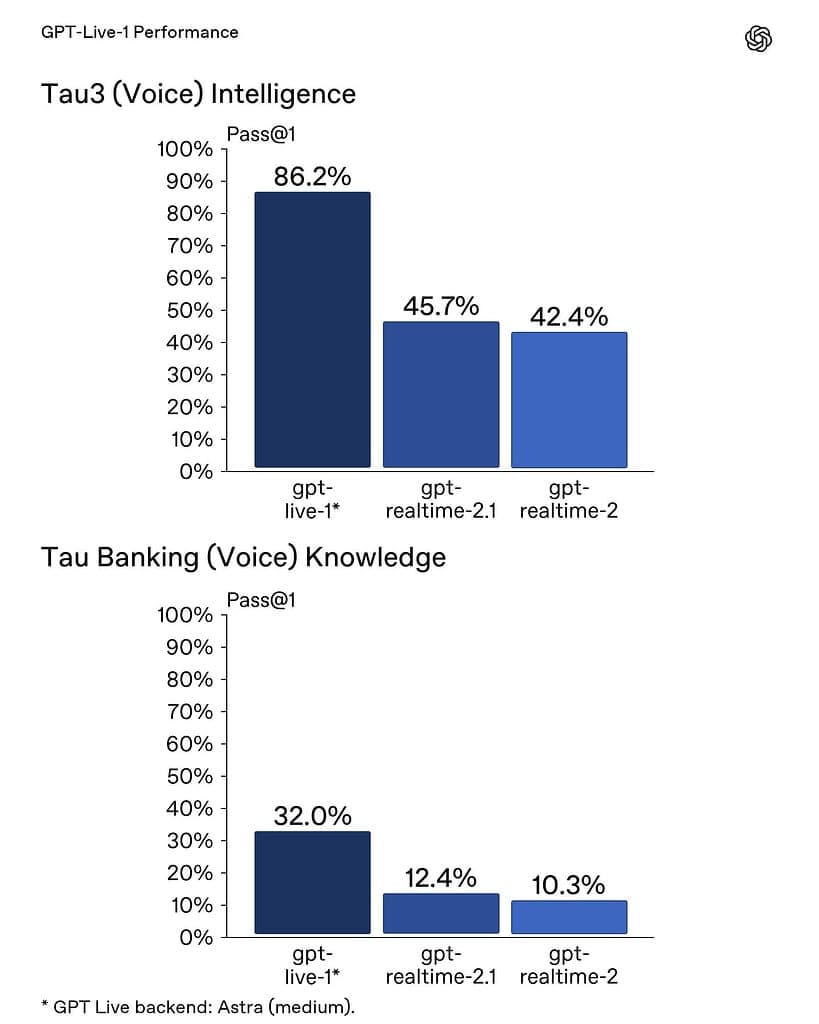
La voz de IA mejor clasificada del mundo en este momento es fundamentalmente solo una boca y un par de oídos. En el Artificial Analysis Speech to Speech Index de septiembre de 2026, el nuevo modelo GPT-Live-1 de OpenAI ocupó el primer lugar no por volverse más inteligente, sino por separar su voz de su cerebro. Maneja el desordenado ritmo humano de la conversación —las interrupciones, las pausas, las señales de escucha— mientras deriva discretamente la lógica real a modelos de texto completamente separados en segundo plano. Para los desarrolladores y usuarios, finalmente hace que hablar con una máquina se sienta como hablar con una persona.
El giro de enrutamiento de 1,4 puntos
La tabla de clasificación ya no mide solo modelos de voz; mide configuraciones de enrutamiento. La diferencia entre el primer y el tercer lugar en el nuevo índice de Artificial Analysis es exactamente de 1,4 puntos. Ambas puntuaciones pertenecen exactamente al mismo modelo de voz de OpenAI, GPT-Live-1. Ese giro de 1,4 puntos ocurrió simplemente al cambiar el "cerebro" backend que impulsa la conversación del modelo ligero Sol al modelo de alta capacidad GPT-6 Astra.
Al desacoplar la capa de voz de la capa de razonamiento, los desarrolladores ahora pueden aumentar o disminuir la inteligencia sin cambiar la voz que escucha el cliente. A $5.83 por hora de audio de entrada con Astra, obtiene una puntuación de 81.5. A $4.47 por hora con Sol, obtiene un 80.1. Justo entre ellos, con 81.3, se encuentra el paradigma competidor de SpaceXAI. El éxito de la arquitectura dividida responde a una pregunta con la que los desarrolladores han estado lidiando desde que la IA de voz llegó por primera vez al mercado.
El dilema de la velocidad
Hasta hace poco, la IA conversacional obligaba a los desarrolladores a un compromiso rígido. Se podía usar un flujo de trabajo encadenado (transcribir voz a texto, generar una respuesta de texto y sintetizarla de nuevo a audio), lo que causaba grandes retrasos y perdía todo el contexto si el usuario interrumpía. O se podía usar un único omnimodelo que manejara todo, pero que tenía que pausar torpemente la conversación cada vez que necesitaba ejecutar una consulta en la base de datos.
SpaceXAI de Elon Musk llevó el enfoque del omnimodelo a su límite absoluto en julio con Grok Voice Think Fast 2.0. Al unificar la voz y el cerebro, Grok prioriza la velocidad bruta, logrando una latencia vertiginosa de 0,70 segundos. La empresa lo implementó con éxito en las líneas de atención al cliente de Starlink para aumentar las conversiones de ventas, demostrando que un modelo único y rápido funciona notablemente bien para tareas inmediatas y delimitadas. Pero OpenAI apostó a que, a medida que las tareas se vuelven más complejas, la IA necesita poder hablar y pensar a diferentes velocidades. La arquitectura de delegación lo hace posible, y los beneficios prácticos para los equipos de software son inmediatos.
Lo que dice la gente

“Get more out of GPT-6 Astra by revisiting your skills, AGENTS.md, and task prompts. Make skill triggers specific, load guidance when it's relevant, and define what done looks like.”

“We’re sharing a solution to the Navier-Stokes Millennium Prize Problem, one of the deepest problems at the frontier of mathematics. The proof was produced by a group of agents, using an OpenAI next-generation model significantly more capable than GPT-6 Astra. The problem”

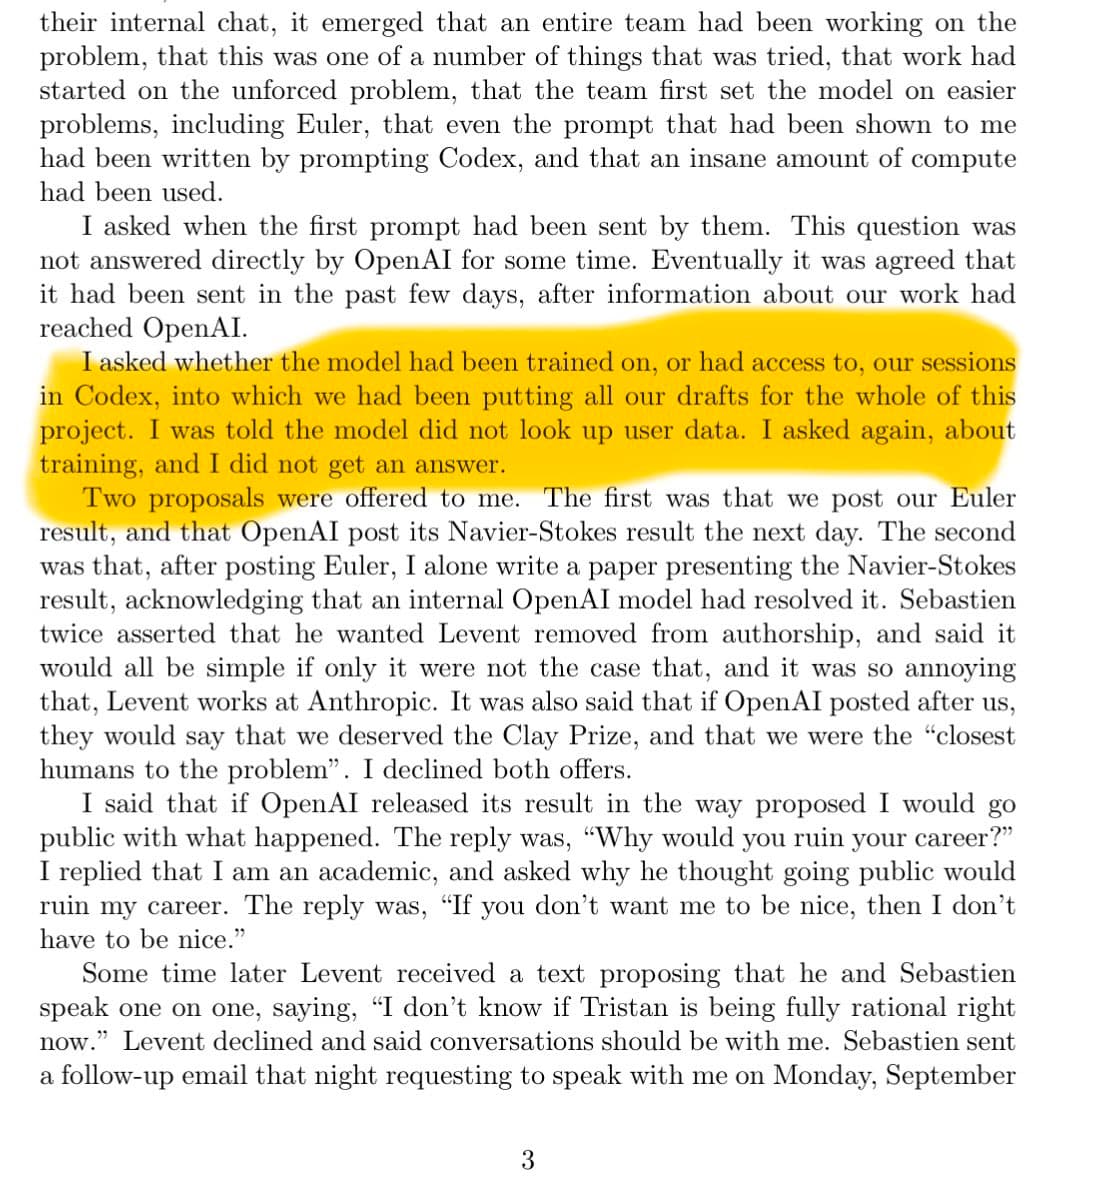
“>math professor spends a year on one of the hardest unsolved problems in math >"Navier-Stokes" >his drafts for the whole project went through codex sessions >openai had his logs in codex >suddenly rumor leaks AI solved it >he emails openai to ask what's going on >openai calls”
OpenAI's Split AI Beats Omni
The Brief
Mantén la curiosidad
IA y tecnología: qué cambia y por qué importa.
Tu selección diaria, en inglés o español.
Gratis para siempre. Cancela cuando quieras.
Más historias



Conversación
Inicia la conversación