
 The Specialty News
Les modèles d'OpenAI tirent jusqu'à 14 % de plus du GPU phare d'AMD
AMD a obtenu environ un an de progrès en conception de puces en moins de cinq mois, et une partie des changements figure déjà dans un design envoyé en fabrication.
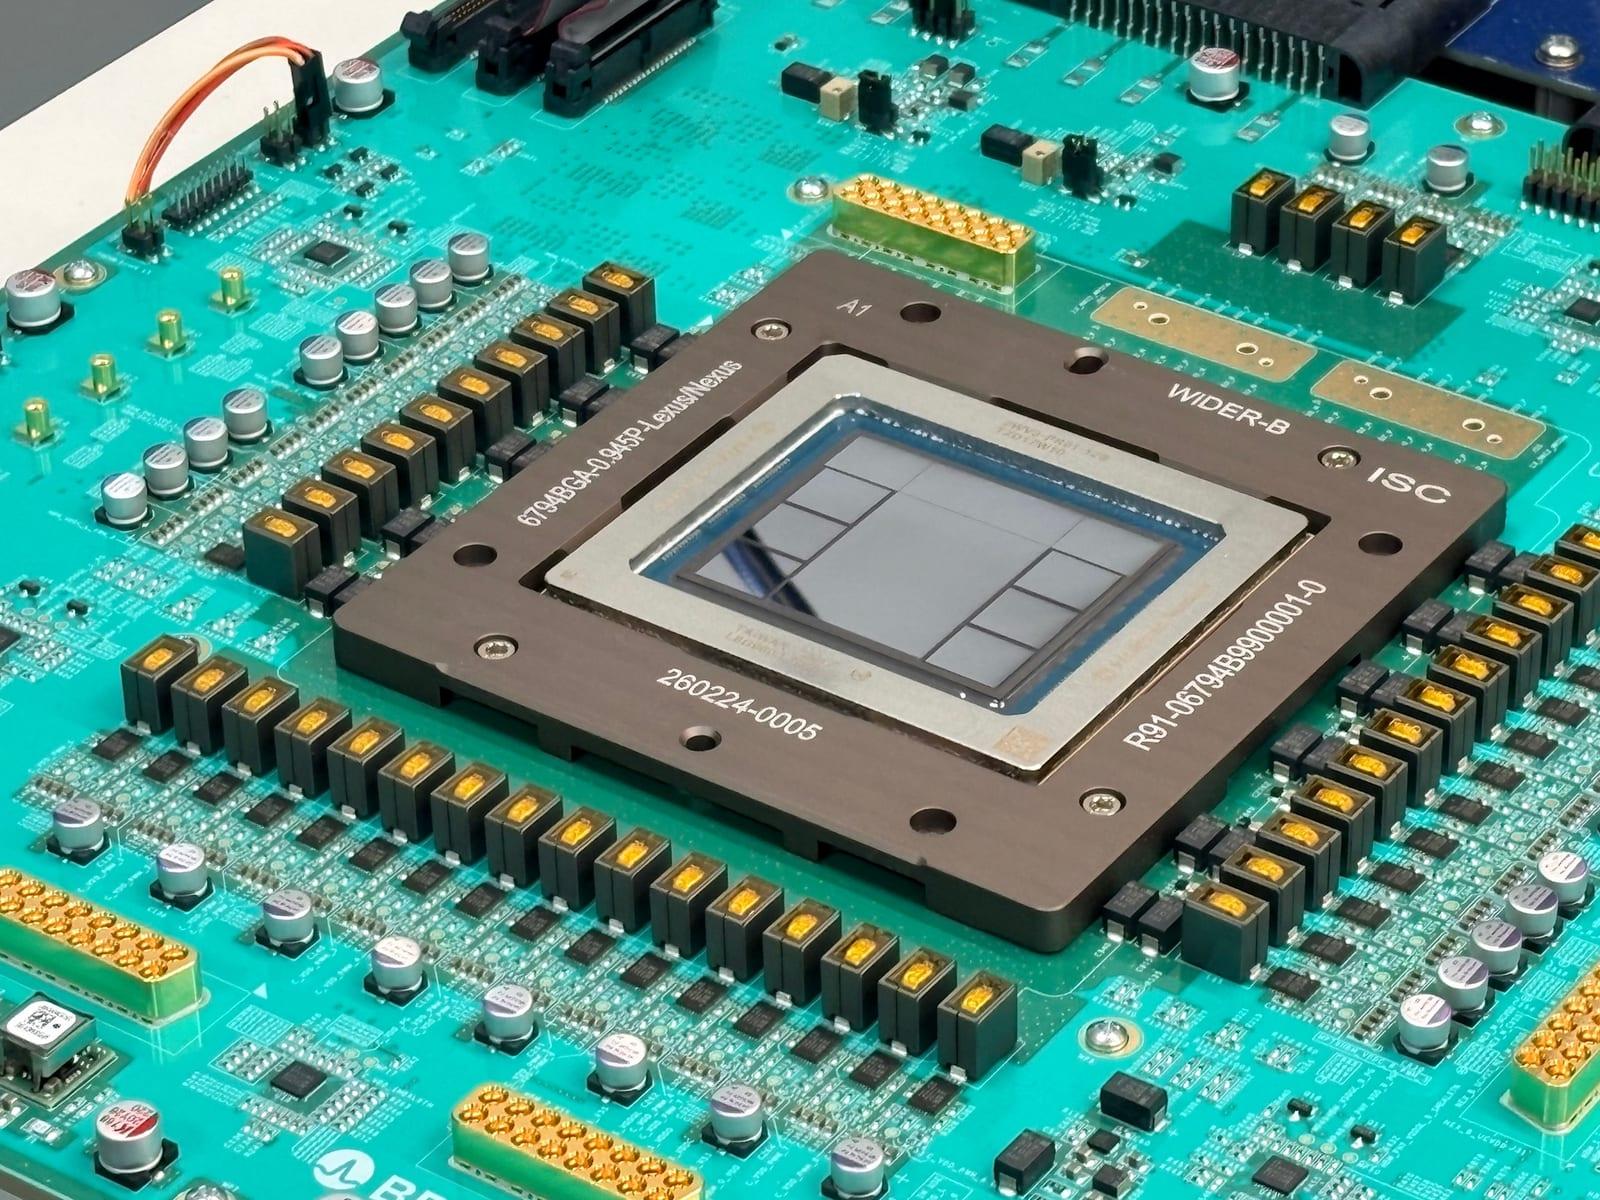
Un multiplicateur de la puce Jalapeño d'OpenAI boucle désormais ses calculs en un cycle d'horloge au lieu de deux, sur environ 15 % de silicium en moins, et cette refonte vient d'un modèle d'IA. Le 18 novembre, OpenAI a expliqué que la même méthode avait apporté à AMD jusqu'à 14 % de gain en consommation, performance et surface sur le design de son GPU phare, soit environ un an de progrès en moins de cinq mois. Les modèles qui tournent sur les puces commencent à améliorer ces mêmes puces.
Un an de progrès en moins de cinq mois
Les concepteurs de puces jugent leur travail sur trois chiffres à la fois, ce qu'ils appellent le PPA : la puissance consommée par un circuit, sa vitesse et la quantité de silicium qu'il occupe. Faire bouger l'un d'eux sur un design mature est un travail lent, car les gains faciles ont été pris il y a des années.
Les modèles d'OpenAI en ont pourtant trouvé d'autres. Avec AMD, ils ont réécrit le code qui décrit les circuits de la puce, écrit dans un langage appelé SystemVerilog, et amélioré le design du GPU phare d'AMD jusqu'à 14 % face à des bases déjà très optimisées. OpenAI parle d'environ un an de progrès obtenu en moins de cinq mois.
Ces changements ne restent pas sur le papier. AMD en a déjà intégré certains dans un design récent envoyé en fabrication et en a ajouté d'autres à ses fichiers de production pour les versions futures. Sur son prochain CPU phare de nouvelle génération, AMD a vérifié des gains à un chiffre sur des blocs clés grâce à des designs écrits par le modèle.
Les gains sur les puces d'AMD sont venus après un premier essai plus discret, sur le matériel qu'OpenAI connaît le mieux : le sien.
Un cycle d'horloge au lieu de deux
OpenAI a commencé à utiliser GPT-o3 mini pour aider à concevoir Jalapeño, sa première puce d'inférence maison, début 2025. Même ce modèle précoce a trouvé de vraies économies.
Dans l'unité matricielle, le cœur arithmétique de la puce, la refonte d'un multiplicateur a utilisé environ 15 % de surface de cellules en moins tout en ramenant sa latence de deux cycles d'horloge à un. Une autre refonte, celle d'un additionneur, a retiré encore 15 % de surface en gardant ses deux cycles. Dans l'unité vectorielle, qui exécute de nombreux calculs en parallèle, les modèles ont exploré la répartition du travail entre les étages du pipeline afin de partager des éléments matériels et de stocker moins de données intermédiaires.
Au total, OpenAI estime que les propositions du modèle ont réduit la surface de cellules standard d'environ 13 % dans l'unité vectorielle et de 10 % dans l'unité matricielle. Rien de simulé : ces optimisations ont été validées sur du vrai silicium lors de la première mise sous tension de Jalapeño, la puce qu'OpenAI a présentée en août avec une puissance nominale de 700 watts.
“Nous avons vu le modèle raisonner sur le RTL au niveau d'un microarchitecte expert.”— OpenAI
Chaque réécriture est passée par les outils de Synopsys pour vérifier que le bloc se comportait toujours exactement de la même façon. D'où la question évidente : le modèle peut-il concevoir un processeur à partir de zéro ?
Un processeur à partir d'un cahier des charges
Pour suivre les progrès d'une génération de modèles à l'autre, OpenAI a confié à ses modèles deux cœurs de processeur RISC-V open source, PicoRV32 et le cœur Ibex utilisé dans la puce de sécurité OpenTitan, en leur demandant de faire exécuter plus d'instructions par seconde à chacun. Les designs qui échouaient à une vérification, ou dépassaient 16 fois la surface d'origine, obtenaient zéro.
Avec environ 112 000 tokens par essai, GPT-6.2 Astra a obtenu le meilleur score moyen sur les deux cœurs, environ le double de GPT-6 Astra sur PicoRV32. OpenAI a ensuite donné aux modèles uniquement les exigences écrites et les modèles de connexion, en les laissant décider du trajet des données dans le cœur. Les cinq modèles ont obtenu de meilleurs scores en concevant à partir du cahier des charges qu'en améliorant le design existant, sur 9 881 essais notés au total.
OpenAI dit clairement ce qui reste à résoudre. Un cœur conçu de zéro peut se passer de fonctions comme les compteurs de performance, peu utiles sur les charges de test, ce qui pourrait expliquer une partie de cet avantage. Exiger ces fonctions, resserrer la limite de surface et vérifier la synchronisation après la synthèse physique rapprocherait le test du travail de production.
La prochaine étape s'appelle GPT-Synopsys, un modèle qu'OpenAI entraîne avec Synopsys pour utiliser les mêmes outils de conception automatisée que les ingénieurs puces professionnels. Pour les ingénieurs d'AMD, c'est un collègue infatigable qui leur a déjà rendu des mois. Les puces qui entraîneront les modèles de demain sont déjà en partie conçues par ceux d'aujourd'hui.
From Jalapeño to AMD's Flagship
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles
Conversation
Lancer la conversation