
 The Specialty News
Los modelos de OpenAI sacan hasta un 14% más a la GPU estrella de AMD
AMD logró cerca de un año de avances en diseño de chips en menos de cinco meses, y parte de los cambios ya está en un diseño enviado a fabricar.
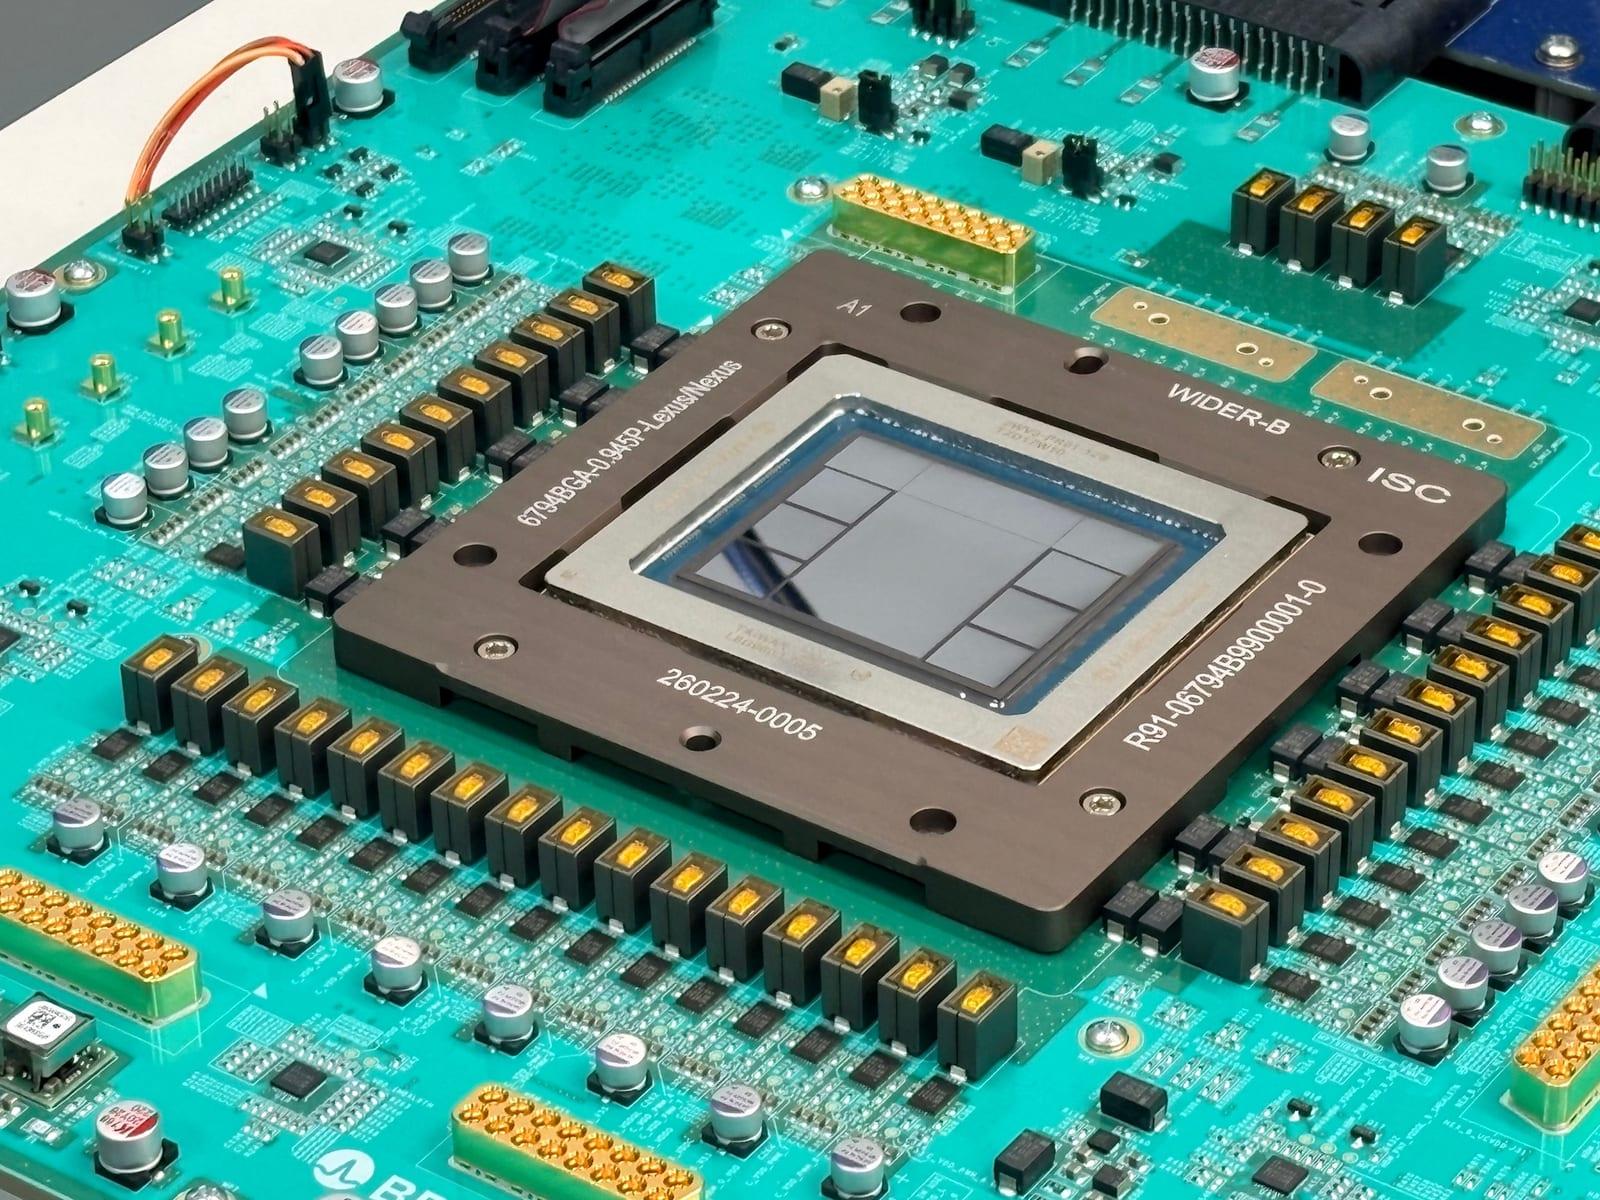
Un multiplicador del chip Jalapeño de OpenAI termina ahora sus cálculos en un ciclo de reloj en lugar de dos, con un 15% menos de silicio, y el rediseño salió de un modelo de IA. El 18 de noviembre OpenAI contó que el mismo método encontró para AMD hasta un 14% de mejora en consumo, rendimiento y superficie en el diseño de su GPU estrella, cerca de un año de avances en menos de cinco meses. Los modelos que corren sobre los chips empiezan a mejorar esos mismos chips.
Un año de avances en menos de cinco meses
Los diseñadores de chips juzgan su trabajo con tres números a la vez, lo que llaman PPA: cuánta energía consume un circuito, a qué velocidad va y cuánto silicio ocupa. Mover cualquiera de ellos en un diseño maduro es un trabajo lento, porque las mejoras fáciles se agotaron hace años.
Aun así, los modelos de OpenAI encontraron más. Junto a AMD, reescribieron el código que describe los circuitos del chip, escrito en un lenguaje llamado SystemVerilog, y mejoraron el diseño de la GPU estrella de AMD hasta un 14% frente a bases que ya estaban muy optimizadas. OpenAI lo cifra en cerca de un año de avances logrado en menos de cinco meses.
Los cambios no se quedan en el papel. AMD ya metió algunos en un diseño reciente que envió a fabricar y añadió otros a sus archivos de producción para versiones futuras. En su próxima CPU estrella de nueva generación, AMD verificó mejoras de un solo dígito porcentual en bloques clave con diseños escritos por el modelo.
Las mejoras en los chips de AMD llegaron después de un ensayo más discreto en el hardware que OpenAI conoce mejor: el suyo.
Un ciclo de reloj en lugar de dos
OpenAI empezó a usar GPT-o3 mini para ayudar a diseñar Jalapeño, su primer chip propio de inferencia, a principios de 2025. Incluso ese modelo temprano encontró ahorros reales.
En la unidad de matrices, el corazón aritmético del chip, el rediseño de un multiplicador usó cerca de un 15% menos de área de celdas y redujo su latencia de dos ciclos de reloj a uno. Otro rediseño, el de un sumador, recortó otro 15% de área y mantuvo sus dos ciclos. En la unidad vectorial, que ejecuta muchos cálculos en paralelo, los modelos exploraron cómo repartir el trabajo entre las etapas del pipeline para compartir piezas de hardware y guardar menos datos intermedios.
En total, OpenAI calcula que las propuestas del modelo redujeron el área de celdas estándar cerca de un 13% en la unidad vectorial y un 10% en la de matrices. No fueron simulaciones: las optimizaciones se probaron en silicio real cuando Jalapeño se encendió por primera vez, el chip que OpenAI presentó en agosto con una potencia nominal de 700 vatios.
“Hemos visto al modelo razonar sobre RTL al nivel de un microarquitecto experto.”— OpenAI
Cada reescritura pasó por las herramientas de Synopsys para comprobar que el bloque seguía comportándose exactamente igual. Lo que plantea la pregunta obvia: ¿puede el modelo diseñar un procesador desde cero?
Un procesador a partir de una ficha técnica
Para seguir el avance de una generación de modelos a la siguiente, OpenAI dio a sus modelos dos núcleos de procesador RISC-V de código abierto, PicoRV32 y el núcleo Ibex que usa el chip de seguridad OpenTitan, y les pidió que cada uno ejecutara más instrucciones por segundo. Los diseños que fallaban una comprobación, o que pasaban de 16 veces el área original, puntuaban cero.
Con unos 112.000 tokens por intento, GPT-6.2 Astra logró la puntuación media más alta en los dos núcleos, cerca del doble que GPT-6 Astra en PicoRV32. Después, OpenAI entregó a los modelos solo los requisitos por escrito y las plantillas de conexión, y les dejó decidir cómo circulan los datos por el núcleo. Los cinco modelos puntuaron más alto diseñando desde la ficha que mejorando el diseño existente, en 9.881 intentos puntuados en total.
OpenAI es clara sobre lo que queda por resolver. Un núcleo diseñado desde cero puede prescindir de funciones como los contadores de rendimiento, que aportan poco en las pruebas, y eso podría explicar parte de la ventaja. Exigir esas funciones, ajustar el límite de área y comprobar los tiempos tras la síntesis física acercaría la prueba al trabajo de producción.
El siguiente paso es GPT-Synopsys, un modelo que OpenAI entrena con Synopsys para usar las mismas herramientas de diseño automatizado en las que confían los ingenieros de chips profesionales. Para los ingenieros de AMD, eso es un colega incansable que ya les ha devuelto meses. Los chips que entrenarán los modelos de mañana ya los diseñan, en parte, los de hoy.
From Jalapeño to AMD's Flagship
The Brief
Mantén la curiosidad
IA y tecnología: qué cambia y por qué importa.
Tu selección diaria, en inglés o español.
Gratis para siempre. Cancela cuando quieras.
Más historias
Conversación
Inicia la conversación