
 The Specialty News
Google DeepMind décroche 82.6 en qualité d'IA vocale, libérant des modèles qui réfléchissent tout en parlant
Gemini 3.8 Live Extended Thinking remplace les lourdes architectures en cascade par un modèle unique qui commente sa progression sur des tâches de fond pour $0.005 par minute.
Lors d'une récente démonstration, un développeur brandit un croquis sommaire sur tableau blanc, et une IA commence à écrire le code React pour le construire tout en commentant naturellement sa progression de vive voix. Il n'y a pas d'icône de chargement, pas de silence gênant et pas de temps d'attente rigide. Avec le lancement le 15 septembre de Gemini 3.8 Live et Extended Thinking, Google DeepMind a résolu le problème des «blancs» dans l'IA conversationnelle. En permettant à un modèle de raisonner et d'exécuter des appels API indépendamment de sa production vocale, le système agit moins comme un moteur de requête statique et davantage comme un collaborateur fluide en temps réel.
La fin de l'ère du talkie-walkie
Jusqu'à cette semaine, créer un assistant vocal nécessitait d'assembler des modèles distincts pour la reconnaissance vocale, le raisonnement et la synthèse vocale. Cette approche en cascade imposait un rythme rigide aux utilisateurs: vous posez une question, le bot s'arrête pour lancer un appel API, et vous attendez en silence. Les ingénieurs de Google DeepMind Tom Ouyang et Malini Jaganathan ont conçu les nouveaux modèles Gemini pour briser cette séquence, permettant à l'IA de traiter des tâches en arrière-plan tout en maintenant la conversation active au premier plan.
Ce changement rappelle la transition dans les télécoms des radios push-to-talk half-duplex — où une seule personne peut parler à la fois — vers les téléphones mobiles full-duplex. Grâce à un nouveau mécanisme appelé appel de fonction asynchrone, Gemini 3.8 Live gère nativement 97 langues au milieu d'une phrase et utilise des mots de remplissage naturels, comme «Laissez-moi vérifier ça», pour gagner du temps. Il se comporte exactement comme le ferait un collègue humain cherchant un fichier sur son ordinateur.
Le standard de 82.6 et le nouveau prix plancher
Pour mesurer le succès de cette interaction fluide, l'industrie utilise le Artificial Analysis Speech to Speech Quality Index. Ce benchmark évalue le naturel avec lequel une IA gère les interruptions, les raisonnements complexes et le rythme verbal.
Cette nouvelle version détrône GPT-Live-1 Astra d'OpenAI, qui affichait 81.5, et Grok Voice Think Fast 2.0 de SpaceXAI à 81.3. Au-delà du record de performance, la Gemini Audio Team y est parvenue avec un prix plancher extrêmement évolutif pour les développeurs. L'accès coûte $0.005 par minute pour l'entrée audio et $0.018 par minute pour la sortie audio, rendant les sessions vocales continues viables pour les applications grand public.
“Il offre une intelligence accrue pour les flux de travail complexes tout en maintenant un flux conversationnel ininterrompu.”— Tom Ouyang
La mort du serveur vocal d'entreprise
La capacité de fouiller dans des bases de données en pleine conversation transforme l'assistance en entreprise. Bob Van Osten, vice-président du produit pour Agentforce chez Salesforce, déploie déjà le modèle pour remplacer les serveurs vocaux automatisés par des agents qui naviguent dans des bases de données d'entreprise complexes sans laisser les clients écouter une musique d'attente.
Les bénéficiaires les plus évidents sont les professionnels travaillant avec leurs mains. Un technicien sur le terrain réparant une baie de serveurs peut pointer sa caméra sur le matériel et expliquer le problème de vive voix. Comme le modèle traite l'entrée vidéo en direct en même temps que la voix, il peut reconnaître le modèle de serveur spécifique, afficher le manuel du fabricant en arrière-plan et guider verbalement le technicien pour la réparation. Le technicien n'a jamais besoin de poser ses outils, de regarder un écran ou d'attendre un délai de traitement.
Repenser le protocole asynchrone
Ce traitement en parallèle exige une réécriture fondamentale de la façon dont les développeurs créent des applications d'IA. Puisque Gemini «réfléchit» désormais indépendamment de sa parole, la documentation de Google avertit que l'ancien signal `turnComplete: true` ne signifie plus que l'IA a terminé. Le modèle peut s'arrêter de parler mais continuer à exécuter des appels API en arrière-plan pour achever une tâche.
Les développeurs doivent maintenant surveiller un tout nouveau protocole asynchrone pour suivre l'état réel du modèle. De plus, le modèle Extended Thinking dispose d'une limite d'entrée massive de 131,072 tokens. Bien que le coût à la minute soit faible, laisser un agent réfléchir indéfiniment en arrière-plan sur des tâches complexes nécessite un plafonnement strict côté client pour éviter des factures API exorbitantes. Résoudre ces obstacles structurels débloque une interface totalement nouvelle. L'IA vocale franchit le cap, passant d'une machine que l'on interroge à un collaborateur travaillant à nos côtés.
Ce que les gens en disent

“Google Might Have Achieved RSI - Around August, Google co-founder Sergey Brin was pushing resource allocation toward Recursive Self-Improvement (RSI) in Google/s AI efforts. - Google DeepMind is now near RSI, and they could announce it anytime. - For those who don't know, RSI”
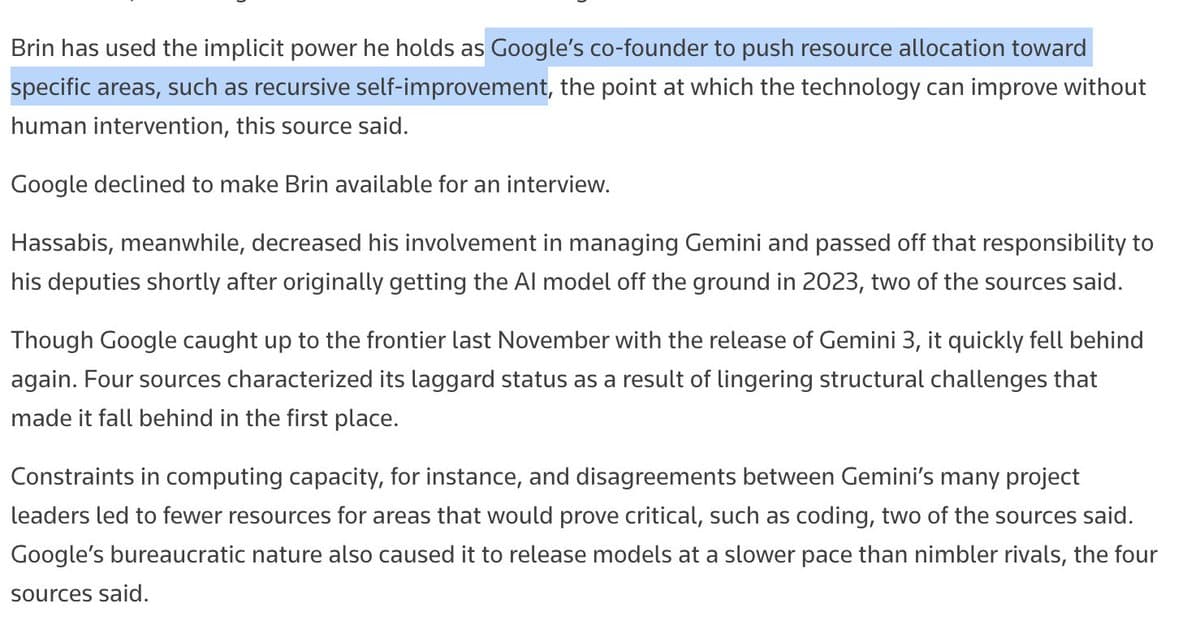

“If Google DeepMind has literally achieved RSI, it’s so over for everyone.”
Gemini 3.8 Ends Voice Dead Air
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles



Conversation
Lancer la conversation