
 The Specialty News
Google DeepMind logra un 82.6 en calidad de IA de voz y desbloquea modelos que piensan mientras hablan
Gemini 3.8 Live Extended Thinking reemplaza las torpes arquitecturas en cascada con un único modelo que narra su progreso en tareas en segundo plano a $0.005 por minuto.
En una demostración reciente, un desarrollador sostiene un boceto rudimentario en una pizarra, y una IA comienza a escribir el código React para construirlo mientras narra casualmente su progreso por voz. No hay un indicador de carga, ni silencios incómodos, ni un período de espera rígido. Con el lanzamiento el 15 de septiembre de Gemini 3.8 Live y Extended Thinking, Google DeepMind ha resuelto el problema del "silencio en antena" en la IA conversacional. Al permitir que un modelo razone y ejecute llamadas a la API de forma independiente a su salida de voz, el sistema actúa menos como un motor de consultas estático y más como un colaborador fluido en tiempo real.
El fin de la era del walkie-talkie
Hasta esta semana, construir un asistente de voz requería unir modelos separados para conversión de voz a texto, razonamiento y texto a voz. Este enfoque en cascada imponía un ritmo rígido a los usuarios: haces una pregunta, el bot se detiene para ejecutar una llamada a la API y esperas en silencio. Los ingenieros de Google DeepMind, Tom Ouyang y Malini Jaganathan, diseñaron los nuevos modelos Gemini para romper esa secuencia, permitiendo a la IA procesar tareas en segundo plano mientras mantiene activa la conversación en primer plano.
El cambio refleja la transición de las telecomunicaciones de las radios semidúplex de pulsar para hablar —donde solo una persona puede hablar a la vez— a los teléfonos móviles full-duplex. A través de un nuevo mecanismo llamado llamada de funciones asíncronas, Gemini 3.8 Live maneja de forma nativa 97 idiomas a mitad de frase y utiliza frases de relleno naturales, como "Déjame revisar eso", para ganar tiempo. Se comporta exactamente como lo haría un colega humano mientras busca un archivo en su computadora.
El estándar de 82.6 y el nuevo piso de costos
Para medir el éxito de esa interacción fluida, la industria utiliza el Artificial Analysis Speech to Speech Quality Index. El punto de referencia evalúa con qué naturalidad una IA maneja interrupciones, razonamiento complejo y ritmo verbal.
El nuevo lanzamiento destrona a GPT-Live-1 Astra de OpenAI, que tenía un 81.5, y a Grok Voice Think Fast 2.0 de SpaceXAI con 81.3. Más allá del récord de rendimiento, el Gemini Audio Team logró esto con un piso de precios altamente escalable para los desarrolladores. El acceso cuesta $0.005 por minuto para entrada de audio y $0.018 por minuto para salida de audio, lo que hace que las sesiones de voz continuas sean viables para aplicaciones de consumo.
“Ofrece mayor inteligencia para flujos de trabajo complejos mientras mantiene un flujo conversacional ininterrumpido.”— Tom Ouyang
El fin del árbol telefónico empresarial
La capacidad de buscar en bases de datos a mitad de una conversación cambia el aspecto del soporte empresarial. Bob Van Osten, vicepresidente de producto de Agentforce en Salesforce, ya está implementando el modelo para reemplazar los árboles telefónicos automatizados con agentes que navegan por bases de datos corporativas complejas sin dejar a los clientes escuchando música de espera.
Los beneficiarios más claros son los profesionales que trabajan con las manos. Un técnico de campo que repara un rack de servidores puede apuntar su cámara al hardware y hablar sobre el problema. Debido a que el modelo procesa la entrada de video en vivo junto con la voz, puede reconocer el modelo de servidor específico, buscar el manual del fabricante en segundo plano y guiar verbalmente al técnico a través de la reparación. El técnico nunca tiene que soltar sus herramientas, mirar una pantalla o esperar por un retraso de procesamiento.
Reconfigurando el protocolo asíncrono
Este procesamiento en paralelo requiere una reescritura fundamental de cómo los desarrolladores construyen aplicaciones de IA. Debido a que Gemini ahora está "pensando" independientemente de su habla, la documentación de Google advierte que la antigua señal `turnComplete: true` ya no significa que la IA haya terminado. El modelo podría dejar de hablar pero continuar ejecutando llamadas a la API en segundo plano para terminar una tarea.
Los desarrolladores ahora deben monitorear un protocolo asíncrono completamente nuevo para rastrear el estado real del modelo. Además, el modelo Extended Thinking presenta un límite de entrada masivo de 131,072 tokens. Si bien el costo por minuto es bajo, dejar que un agente piense indefinidamente en segundo plano en tareas complejas requiere una limitación estricta del lado del cliente para evitar facturas de API descontroladas. Resolver esos obstáculos estructurales desbloquea una interfaz completamente nueva. La voz de IA está cruzando el umbral de una máquina a la que consultas a un colaborador que trabaja justo a tu lado.
Lo que dice la gente

“Google Might Have Achieved RSI - Around August, Google co-founder Sergey Brin was pushing resource allocation toward Recursive Self-Improvement (RSI) in Google/s AI efforts. - Google DeepMind is now near RSI, and they could announce it anytime. - For those who don't know, RSI”
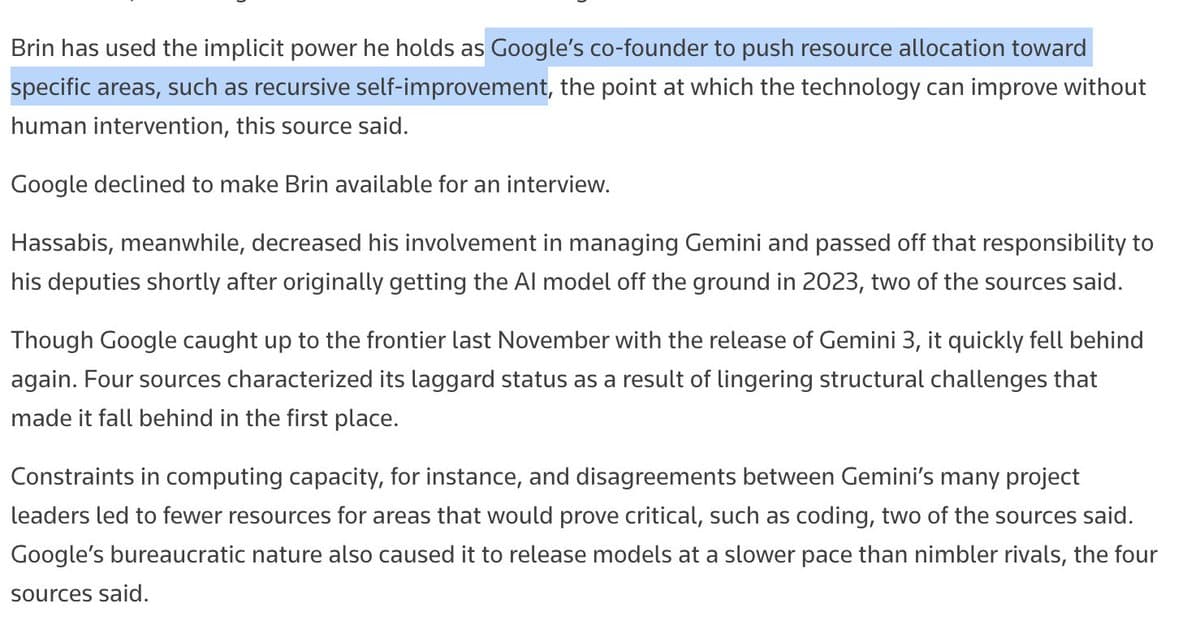

“If Google DeepMind has literally achieved RSI, it’s so over for everyone.”
Gemini 3.8 Ends Voice Dead Air
The Brief
Mantén la curiosidad
IA y tecnología: qué cambia y por qué importa.
Tu selección diaria, en inglés o español.
Gratis para siempre. Cancela cuando quieras.
Más historias



Conversación
Inicia la conversación