
 The Specialty News
Cerebras fait tourner Qwen à 1,500 Tokens a Second, excluant les développeurs qui en ont le plus besoin
Le matériel à l'échelle de la plaquette termine les tâches de codage 2.8x plus vite que les GPU standard, mais une limite brutale de 150,000 tokens et l'absence de remises sur la mise en cache le rendent 5.6x plus cher.
Les utilisateurs du nouveau modèle Qwen 3.8 27B d'Alibaba épuisent leurs limites mensuelles de calcul d'API en exactement une minute et quarante secondes. Le matériel à l'échelle de la plaquette de Cerebras fait tourner l'IA à une vitesse fulgurante de 1,500 tokens par seconde, éliminant de fait l'attente insoutenable de la génération de code. Mais cette vitesse physique brute s'est heurtée à une réalité économique obstinée.
La physique de la latence zéro
Les visionnaires du matériel chez Cerebras veulent éliminer complètement la phase d'attente de l'intelligence artificielle. Les GPU traditionnels gaspillent de précieuses millisecondes à transférer les poids des modèles depuis et vers des banques de mémoire externes. Cerebras contourne ce goulot d'étranglement en gravant l'intégralité du modèle directement dans la mémoire SRAM intégrée à la puce.
Lorsqu'Alibaba a publié Qwen 3.8 27B en open source en août, elle a offert aux développeurs un modèle dense extrêmement performant qui adopte par défaut un état de raisonnement interne agressif. L'IA est incroyablement intelligente, mais elle nécessite une quantité massive de contexte pour suivre le fil de sa pensée. Associer Qwen à Cerebras permet d'obtenir une vitesse d'exécution stupéfiante.
Cette limite de 150,000 tokens semble énorme, mais elle équivaut à peu près au nombre de mots du roman « Dune » de Frank Herbert. À plein régime, Cerebras traite l'intégralité du livre en 100 seconds, atteignant instantanément le plafond de l'utilisateur. Cette vitesse pure crée une tension étrange entre ce que le matériel est capable de faire et ce que l'infrastructure de facturation permet réellement à un développeur d'accomplir.
La pénalité de la mise en cache des requêtes
Les développeurs qui conçoivent des agents d'IA autonomes s'appuient sur une bouée de sauvetage financière spécifique appelée la mise en cache des requêtes. Lorsqu'un agent lit à plusieurs reprises les mêmes dix mille lignes de code pour corriger un bug, les fournisseurs de cloud standard proposent des remises importantes pour la mémorisation du contexte mis en cache.
Ce n'est pas le cas de Cerebras. En raison du fonctionnement fondamental de la SRAM, la lecture d'un contexte mis en cache nécessite autant de ressources physiques sur la puce que le traitement d'une nouvelle requête.
“Les tokens d'entrée, qu'ils soient servis depuis le cache ou traités à nouveau, sont facturés au tarif standard des tokens d'entrée.”— Documentation d'inférence de Cerebras
Le calcul devient rapidement prohibitif. Un développeur a suivi une session type de revue de code avec un taux de réussite du cache de 91.4 percent. Sur un cloud GPU standard, la tâche a pris 14 minutes et a coûté 29 cents. Sur Cerebras, elle s'est terminée en seulement 5 minutes, mais la facture s'est élevée à $1.60. Le matériel est 2.8 fois plus rapide en temps réel, mais près de six fois plus cher pour les flux de travail itératifs. Les développeurs qui adorent cette vitesse réalisent soudain qu'ils ne peuvent pas en payer le prix.
Le prix de l'instantanéité
Cette fracture tarifaire impose une division dans notre manière de concevoir les logiciels. Les applications à enjeux cruciaux, comme la robotique en direct, le trading algorithmique et la traduction vocale en temps réel, exigent des réponses instantanées. Pour ces cas d'usage, payer un surcoût pour éliminer la latence n'est qu'une erreur de l'épaisseur du trait.
Mais les développeurs indépendants qui bricolent des agents de codage asynchrones évoluent dans une tout autre réalité. Les utilisateurs de Hacker News comme *nostrebored* représentent une vague croissante de programmeurs qui adorent cette vitesse pure, mais se sentent exclus par une structure de facturation axée sur les entreprises qui pénalise les requêtes complexes. Si un agent d'IA lit des milliers de lignes de code en arrière-plan pendant qu'un humain va chercher un café, terminer la tâche en five seconds au lieu de fifteen n'apporte aucune utilité réelle.
Le marché est sur le point de tester la valeur réelle que nous accordons à l'instantanéité. Wall Street et les laboratoires de robotique paieront volontiers le prix fort pour éliminer la barre de chargement. Mais pour les agents autonomes censés accomplir nos tâches les plus lourdes en arrière-plan, l'accessibilité financière brute l'emportera toujours sur la vitesse instantanée.
Ce que les gens en disent

“🚀Qwen3.8-Max just got upgraded. Meet Qwen3.8-Max-0902! 2.4T parameters. 1M context tokens. Built for real world complexity. Further post trained on Coding & Cowork, Qwen3.8-Max-0902 now delivers stronger performance across complex enterprise tasks, scientific research, and”

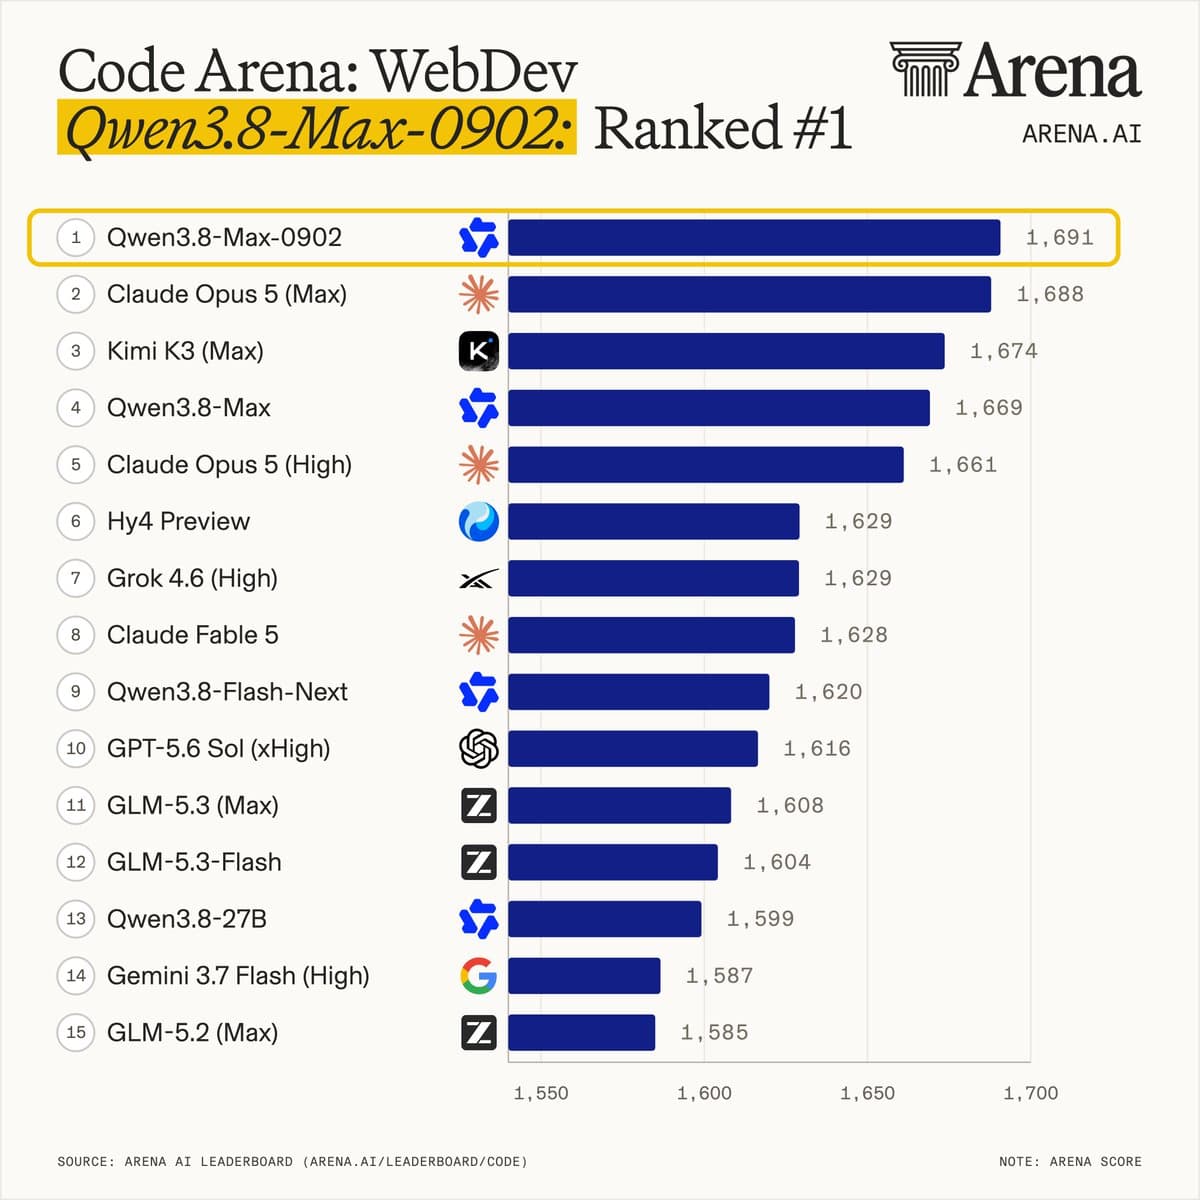
“Big news: Qwen3.8-Max-0902 by @Alibaba_Qwen just debuted at #1 overall in the Code Arena: WebDev with 1691 pts! It scores 3 pts above Claude Opus 5 (Max), 17 pts above Kimi K3 (Max), and 22 pts above the previous Qwen3.8-Max. Priced at a blended $5/MToken, Qwen3.8-Max-0902 also”

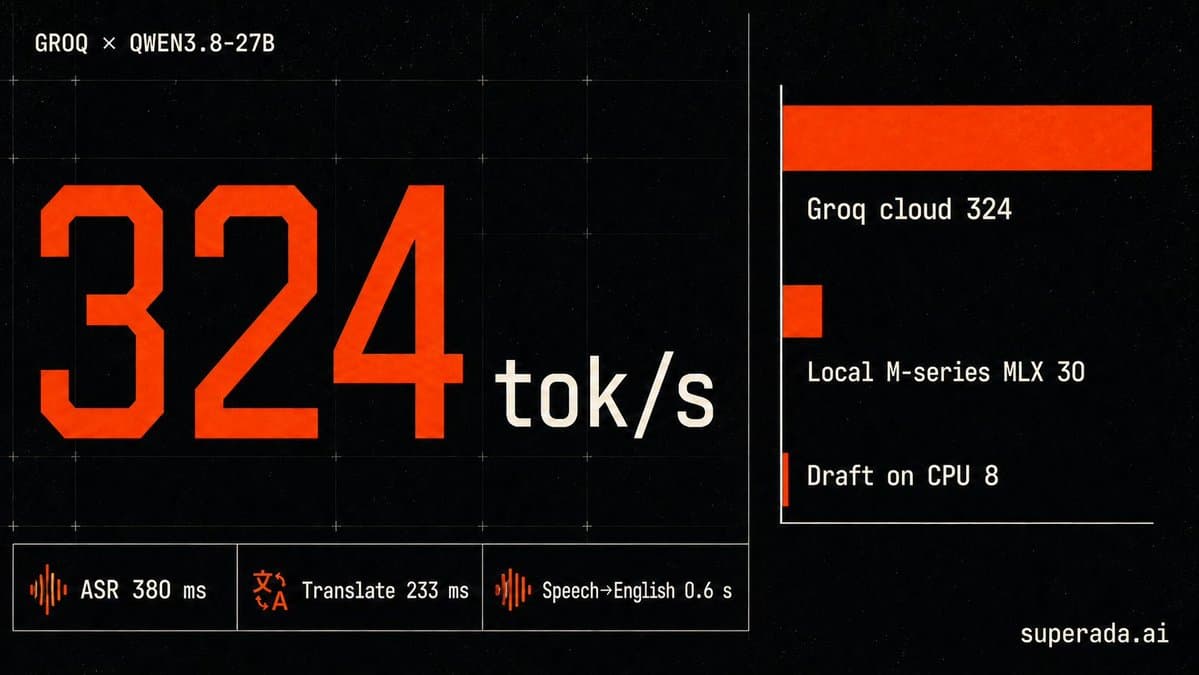
“I'm using Qwen3.8 27B on Groq and its awesome Only limits so far: 1,000 requests/min 8,000 tokens/min (prompt + completion combined)”
Cerebras Speed Costs 5.6x More
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles





Conversation
Lancer la conversation