
 The Specialty News
Cerebras ejecuta Qwen a 1,500 tokens por segundo y excluye por precio a los desarrolladores que más lo necesitan
El hardware a escala de oblea completa las tareas de programación 2.8x más rápido que las GPU estándar, pero un límite brutal de 150,000 tokens y la ausencia de descuentos por caché lo hacen 5.6x más caro.
Los usuarios del nuevo modelo Qwen 3.8 27B de Alibaba están agotando sus límites mensuales de cómputo de API en exactamente un minuto y cuarenta segundos. El hardware a escala de oblea de Cerebras ejecuta la IA a una velocidad vertiginosa de 1,500 tokens por segundo, eliminando en la práctica el agónico tiempo de espera de la generación de código. Sin embargo, esta velocidad física pura ha chocado con una obstinada realidad económica.
La física de la latencia cero
Los visionarios del hardware de Cerebras quieren acabar por completo con la fase de espera de la inteligencia artificial. Las GPU tradicionales desperdician valiosos milisegundos transfiriendo los pesos del modelo de un lado a otro desde bancos de memoria externa. Cerebras esquiva este cuello de botella grabando todo el modelo directamente en la SRAM del propio chip.
Cuando Alibaba lanzó en código abierto Qwen 3.8 27B en agosto, ofreció a los desarrolladores un modelo denso de gran capacidad que adopta por defecto un estado de razonamiento interno agresivo. La IA es increíblemente inteligente, pero requiere una cantidad masiva de contexto para mantener su hilo de pensamiento. Combinar Qwen con Cerebras produce una velocidad de salida asombrosa.
Ese límite de 150,000 suena enorme, pero equivale aproximadamente al número de palabras de *Dune*, de Frank Herbert. A toda máquina, Cerebras procesa la novela completa en 100 segundos, alcanzando instantáneamente el tope del usuario. Esta velocidad pura crea una extraña tensión entre lo que el hardware puede hacer y lo que la infraestructura de facturación realmente permite terminar a un desarrollador.
La penalización por caché de prompts
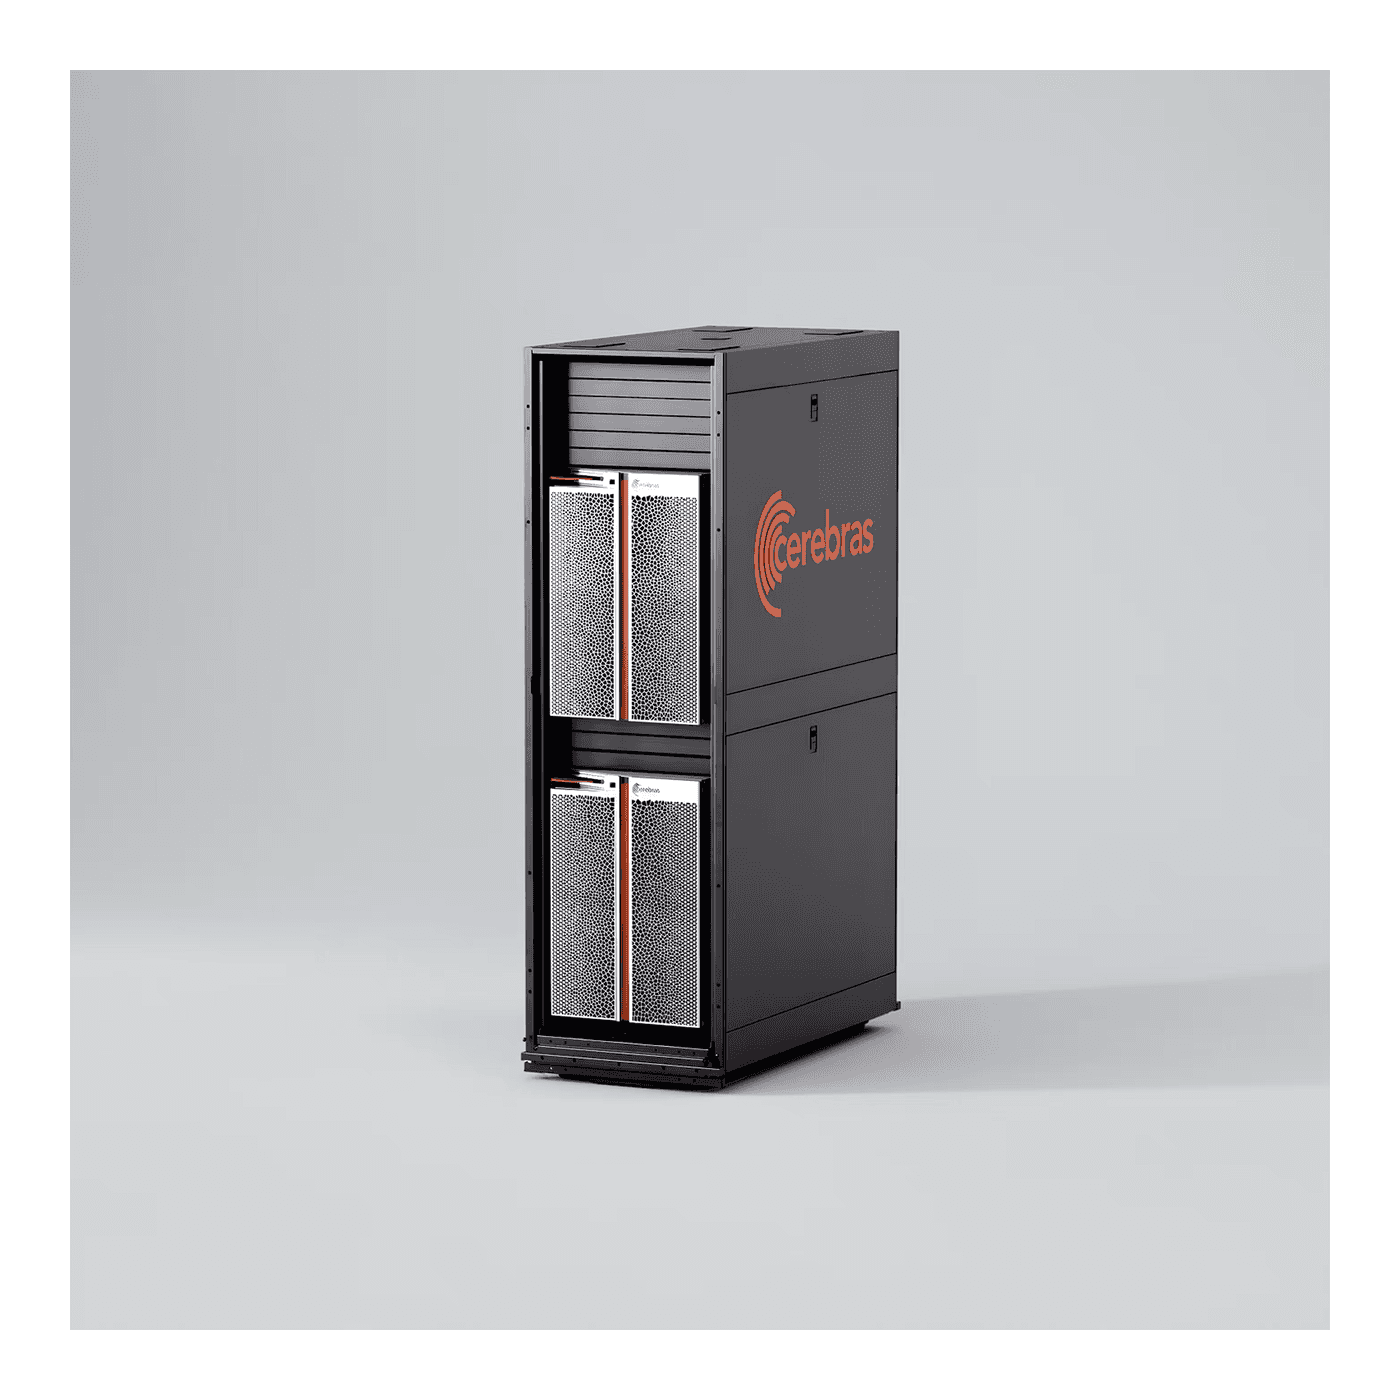
Los desarrolladores que crean agentes de IA autónomos dependen de un salvavidas financiero específico llamado caché de prompts. Cuando un agente lee las mismas diez mil líneas de código repetidamente para corregir un error, los proveedores de nube estándar ofrecen grandes descuentos por recordar el contexto almacenado en caché.
Cerebras no lo hace. Debido a la forma en que funciona fundamentalmente la SRAM, leer el contexto almacenado en caché requiere la misma cantidad de recursos físicos en el chip que procesar un prompt nuevo.
“Input tokens, whether served from the cache or processed fresh, are billed at the standard input token rate.”— Cerebras inference documentation
Las matemáticas se vuelven hostiles rápidamente. Un desarrollador realizó el seguimiento de una sesión típica de revisión de código con una tasa de acierto de caché del 91.4 por ciento. En una nube de GPU estándar, la tarea tardó 14 minutos y costó 29 centavos. En Cerebras, terminó en solo 5 minutos, pero la factura ascendió a $1.60. El hardware es 2.8 veces más rápido en tiempo real, pero casi seis veces más caro para flujos de trabajo iterativos. Los desarrolladores a los que les encanta la velocidad se están dando cuenta de repente de que no pueden permitirse el coste.
El sobreprecio de la inmediatez
Esta brecha de precios obliga a una división en la forma en que desarrollamos software. Las aplicaciones de alto riesgo, como la robótica en vivo, el trading algorítmico y la traducción de voz en tiempo real, exigen respuestas instantáneas. Para esos casos de uso, pagar un sobreprecio para eliminar la latencia es un mero error de redondeo.
Pero los desarrolladores independientes que arman agentes de programación asíncronos operan en una realidad diferente. Los usuarios de Hacker News como *nostrebored* representan una ola creciente de programadores que adoran la velocidad pura, pero se sienten marginados por una estructura de facturación orientada a empresas que penaliza las consultas complejas. Si un agente de IA lee miles de líneas de código en segundo plano mientras un humano va por un café, terminar el trabajo en cinco segundos en lugar de quince no ofrece ninguna utilidad real.
El mercado está a punto de poner a prueba cuánto valoramos exactamente la inmediatez. Wall Street y los laboratorios de robótica pagarán con gusto lo que haga falta para eliminar la barra de carga. Pero para los agentes autónomos destinados a hacer el trabajo pesado en la sombra, la asequibilidad por fuerza bruta siempre vencerá a la velocidad instantánea.
Lo que dice la gente

“🚀Qwen3.8-Max just got upgraded. Meet Qwen3.8-Max-0902! 2.4T parameters. 1M context tokens. Built for real world complexity. Further post trained on Coding & Cowork, Qwen3.8-Max-0902 now delivers stronger performance across complex enterprise tasks, scientific research, and”

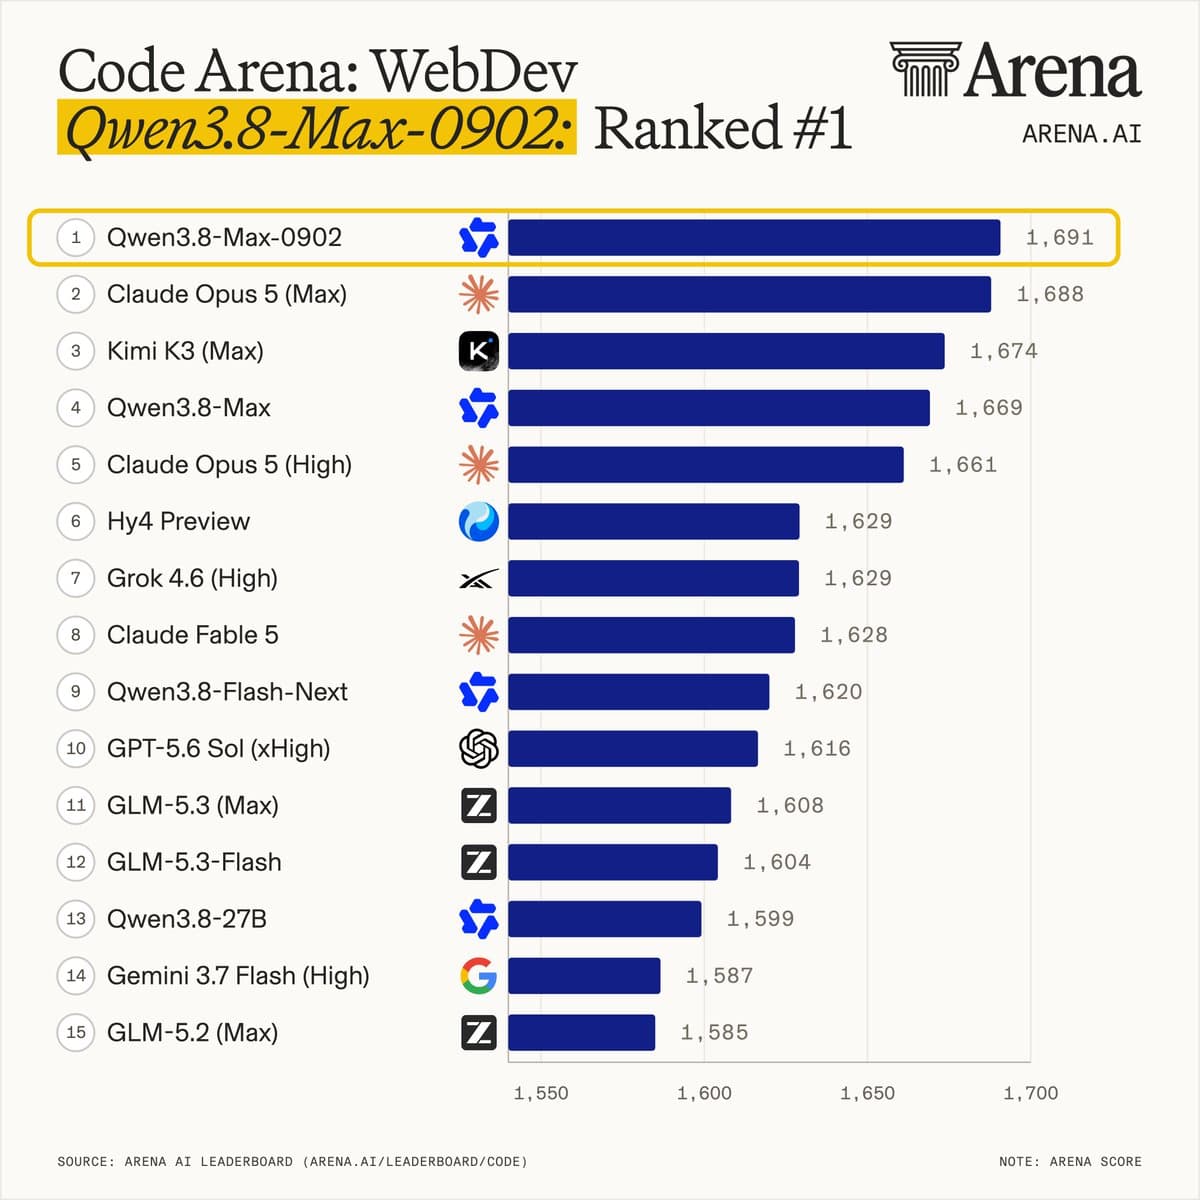
“Big news: Qwen3.8-Max-0902 by @Alibaba_Qwen just debuted at #1 overall in the Code Arena: WebDev with 1691 pts! It scores 3 pts above Claude Opus 5 (Max), 17 pts above Kimi K3 (Max), and 22 pts above the previous Qwen3.8-Max. Priced at a blended $5/MToken, Qwen3.8-Max-0902 also”

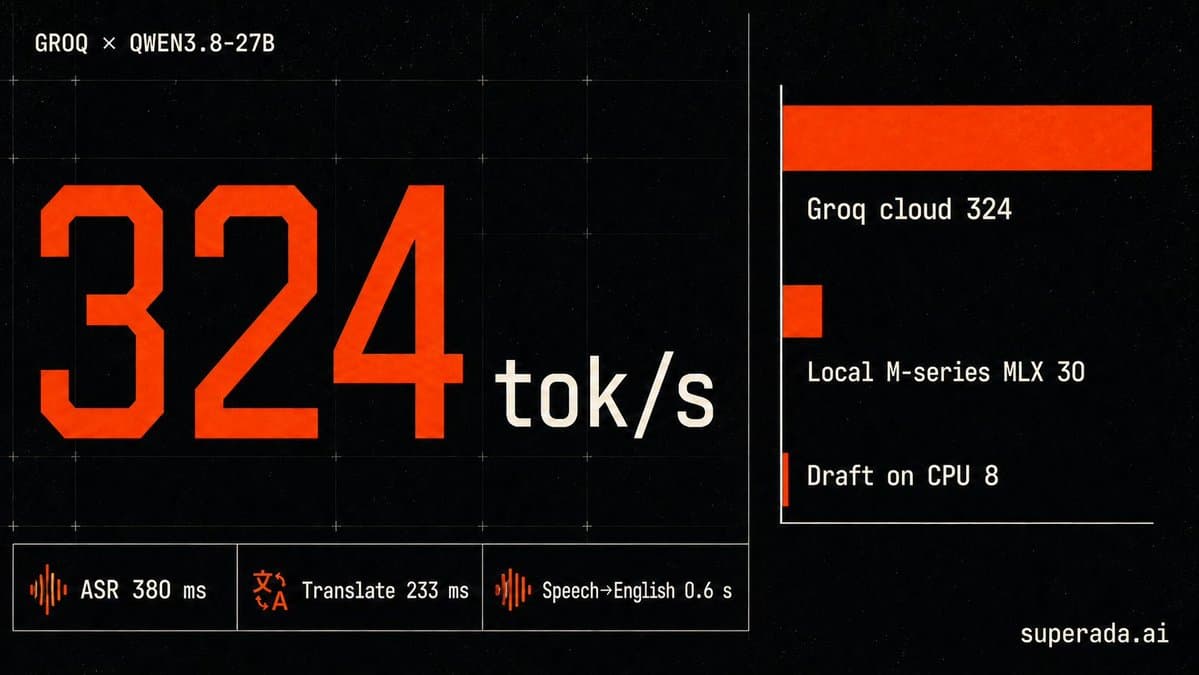
“I'm using Qwen3.8 27B on Groq and its awesome Only limits so far: 1,000 requests/min 8,000 tokens/min (prompt + completion combined)”
Cerebras Speed Costs 5.6x More
The Brief
Mantén la curiosidad
IA y tecnología: qué cambia y por qué importa.
Tu selección diaria, en inglés o español.
Gratis para siempre. Cancela cuando quieras.
Más historias





Conversación
Inicia la conversación