
 The Specialty News
Alibaba lance Qwen4-Max, un modèle de 2 400 milliards de paramètres à 1,50 $ le million de tokens
Le nouveau modèle phare de Qwen lit jusqu'à un million de tokens d'un coup et, selon les calculs d'Alibaba, accomplit la tâche moyenne pour environ 60 % de moins que le modèle qu'il remplace.
Le plus grand modèle d'Alibaba à ce jour compte 2 400 milliards de paramètres et n'en réveille que 71 milliards pour chaque mot qu'il écrit. Qwen4-Max est sorti pour tous le lundi 16 novembre via l'API QwenCloud, au prix de 1,50 $ par million de tokens en entrée et de 4,50 $ par million en sortie. Pour ceux qui construisent des agents, c'est un modèle de taille frontière doté d'une mémoire d'un million de tokens, à un prix qui rend les longues tâches abordables.
71 milliards éveillés sur 2 400 milliards
Qwen4-Max est un modèle à mélange d'experts : un immense réseau découpé en spécialistes, dont seule une petite équipe travaille sur chaque mot. Alibaba indique qu'il conserve les 2 400 milliards de paramètres au total de Qwen3.8-Max, mais en active 25 % de moins par token, soit 71 milliards. Il lit nativement le texte, les images et la vidéo, et sa fenêtre de contexte contient un million de tokens.
Le prix est pensé pour un usage intensif. À 1,50 $ par million de tokens en entrée, faire lire au modèle un livre de 300 pages coûte environ 20 centimes, et l'entrée répétée que le système met en cache tombe à 0,075 $ par million. Alibaba affirme que tous les tarifs sont inférieurs à ceux de son précédent modèle phare, avec une entrée en cache 70 % moins chère.
L'économie la plus importante, selon Alibaba, vient de ce que le modèle utilise moins de mots pour mener une tâche à bien. Sur Work360, son test interne de tâches réelles dans 721 domaines spécialisés, Qwen4-Max a battu Qwen3.8-Max dans l'ensemble en utilisant 35 % de tokens en moins dans son mode de raisonnement High, ce qui réduit le coût moyen par tâche d'environ 60 %.
Ce sont les mesures d'Alibaba elle-même. Son tableau face aux laboratoires américains raconte une histoire plus détaillée.
Là où il devance Opus 5.5, et là où il reste derrière
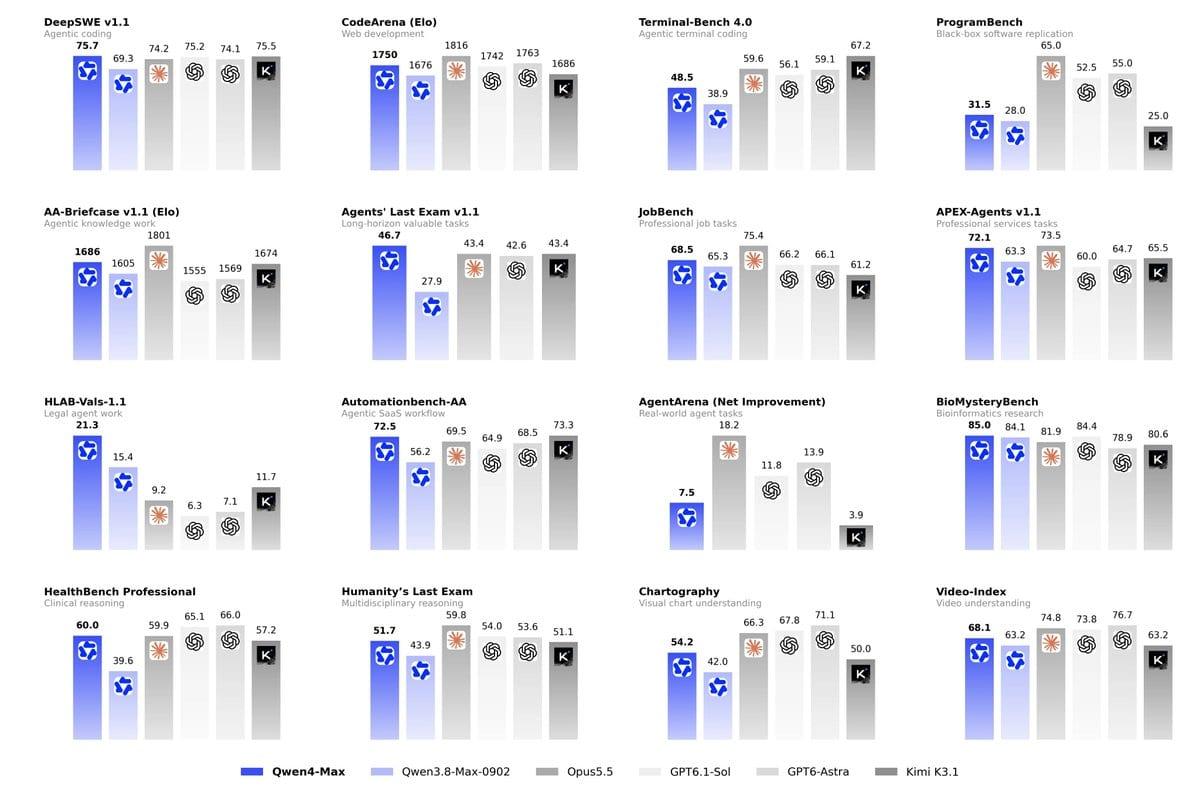
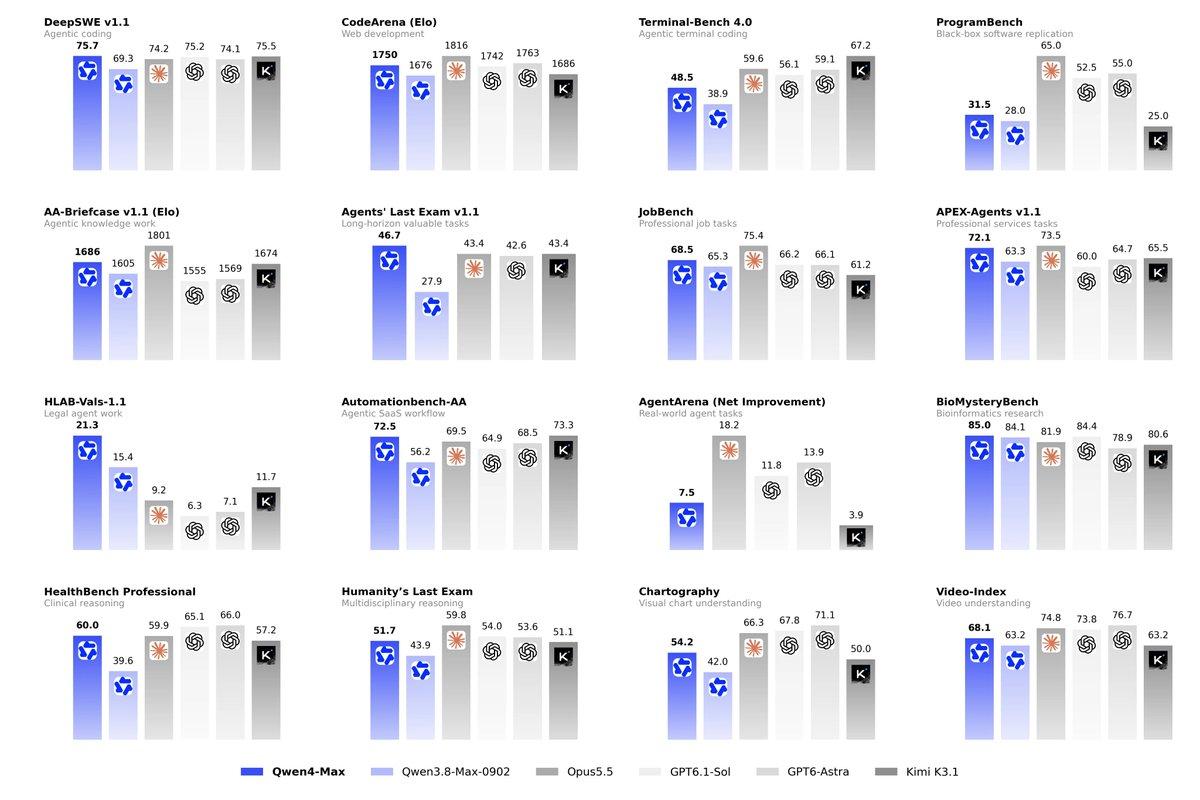
Dans le tableau de résultats publié par Alibaba avec le lancement, Qwen4-Max est comparé à Opus 5.5 d'Anthropic, à GPT-6.1 Sol et GPT-6 Astra d'OpenAI, et à Kimi K3.1 de Moonshot. Il devance Opus 5.5 sur plusieurs tests d'agents : 75,7 contre 74,2 sur DeepSWE, pour la programmation par agents, 46,7 contre 43,4 sur Agents' Last Exam, pour les tâches longues à forte valeur, et 85,0 contre 81,9 sur BioMysteryBench, pour la recherche en bio-informatique. Sur un test d'agents juridiques, HLAB-Vals, il obtient 21,3 contre 9,2 pour Opus 5.5.
Il montre aussi ce qui reste à faire. Sur Terminal-Bench 4.0, qui mesure des agents de programmation travaillant en ligne de commande, Qwen4-Max obtient 48,5 contre 59,6 pour Opus 5.5 et 67,2 pour Kimi K3.1. Sur Humanity's Last Exam, il affiche 51,7 contre 59,8 pour Opus 5.5, et sur Code Arena, un classement public de programmation réelle, Alibaba indique qu'il se classe sixième.
Une première évaluation indépendante va dans le même sens : Artificial Analysis lui a attribué 43 sur son Intelligence Index, au-dessus de la médiane de 41 des modèles comparables. La preuve la plus parlante est peut-être ce qu'Alibaba affirme en avoir déjà fait.
De 475 minutes à 24, et les modèles ouverts à venir
L'annonce d'Alibaba énumère les tâches confiées à Qwen4-Max. Dans la construction automobile, le modèle aurait réduit le temps de programmation manuelle d'une pièce d'environ 475 minutes à 24. Lors d'une exécution de 48 heures d'un agent sans supervision, il a produit une molécule de liquide de refroidissement ensuite validée par des expériences. Dans le cloud d'Alibaba, il a rendu la replanification hors ligne des CPU plus de 14 fois plus rapide.
Le modèle est disponible dès maintenant via l'API de QwenCloud et ses abonnements Token Plan, dans l'application QwenWork et dans Qwen Studio. Ses poids ne sont pas publics : Qwen4-Max ne tourne que sur les serveurs d'Alibaba. L'entreprise a promis que les membres plus petits de la famille suivront en accès ouvert.
“Des modèles à poids ouverts et de plus petite taille de la série Qwen4 seront bientôt publiés pour les développeurs du monde entier.”— Alibaba
Pour une startup qui fait tourner des agents jour et nuit, le calcul change dès aujourd'hui : un modèle doté d'une mémoire d'un million de tokens, à 1,50 $ le million, qui accomplit une plus grande part du travail avec moins de mots.
Ce que les gens en disent

“📢 Meet Qwen4-Max, your new AI teammate for work, creativity, and discovery! Qwen4-Max is built on a new MoE architecture with native vision and a 1M-token context window. Highlights: - Outperforms Qwen3.8-Max with up to ~50% fewer tokens, while average cost per task drops over”
Neck and Neck With Opus 5.5
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles
Conversation
Lancer la conversation