
 The Specialty News
Alibaba lanza Qwen4-Max, un modelo de 2,4 billones de parámetros a 1,50 $ por millón de tokens
El nuevo buque insignia de Qwen lee hasta un millón de tokens de una vez y, según las cuentas de Alibaba, termina la tarea media por un 60 % menos que el modelo al que sustituye.
El mayor modelo de Alibaba hasta ahora tiene 2,4 billones de parámetros y solo despierta 71.000 millones de ellos por cada palabra que escribe. Qwen4-Max salió para todos el lunes 16 de noviembre a través de la API de QwenCloud, a 1,50 $ por millón de tokens de entrada y 4,50 $ por millón de tokens de salida. Para quien construye agentes, es un modelo de tamaño de frontera con una memoria de un millón de tokens a un precio que hace asequibles los trabajos largos.
71.000 millones despiertos de 2,4 billones
Qwen4-Max es un modelo de mezcla de expertos: una red enorme dividida en especialistas, de los que solo un pequeño equipo trabaja en cada palabra. Alibaba dice que mantiene los mismos 2,4 billones de parámetros totales que Qwen3.8-Max, pero activa un 25 % menos por token, 71.000 millones. Lee texto, imágenes y vídeo de forma nativa, y su ventana de contexto admite un millón de tokens.
El precio está pensado para un uso intensivo. A 1,50 $ por millón de tokens de entrada, hacer que el modelo lea un libro de 300 páginas cuesta unos 20 céntimos, y la entrada repetida que el sistema guarda en caché baja a 0,075 $ por millón. Alibaba dice que todos los precios son más bajos que los de su anterior buque insignia, con la entrada en caché un 70 % más barata.
El mayor ahorro, según Alibaba, viene de que el modelo usa menos palabras para terminar un trabajo. En Work360, su prueba interna de tareas reales en 721 campos especializados, Qwen4-Max superó a Qwen3.8-Max en conjunto usando un 35 % menos de tokens en su modo de razonamiento High, lo que reduce el coste medio por tarea en torno a un 60 %.
Son mediciones de la propia Alibaba. Su tabla frente a los laboratorios estadounidenses cuenta una historia más detallada.
Dónde supera a Opus 5.5 y dónde se queda atrás
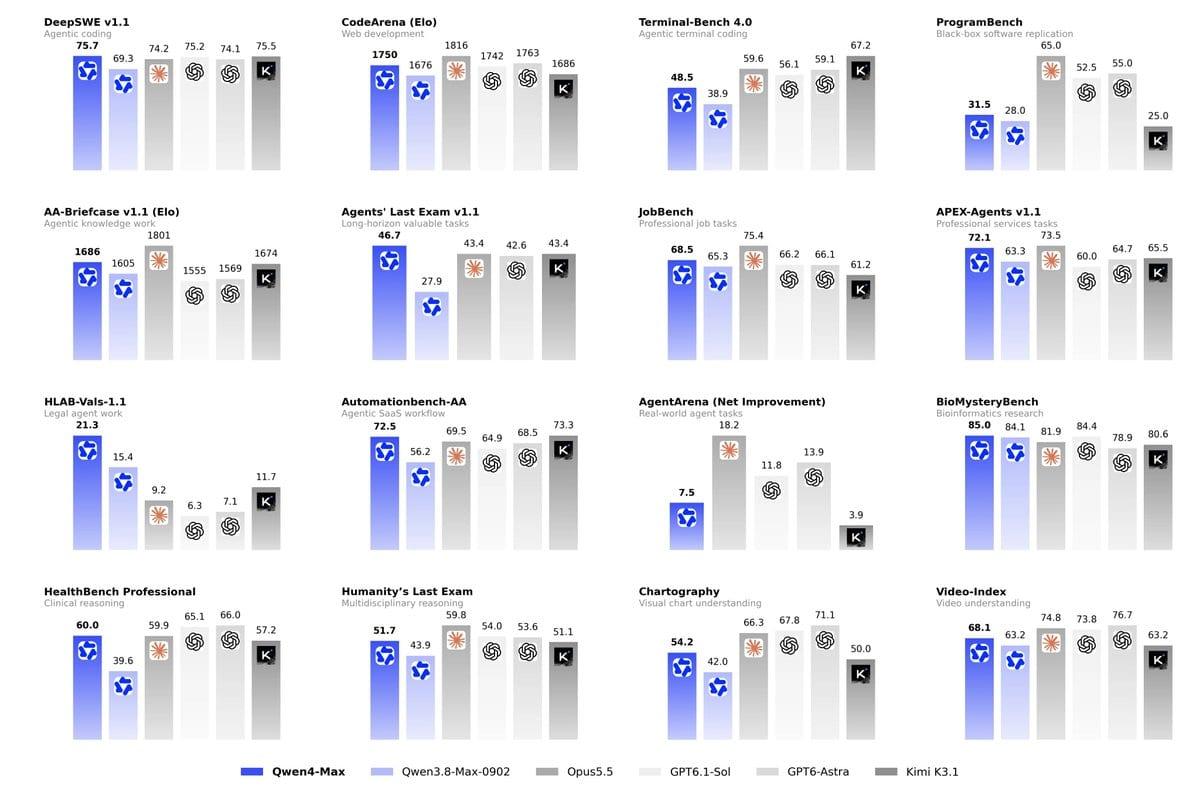
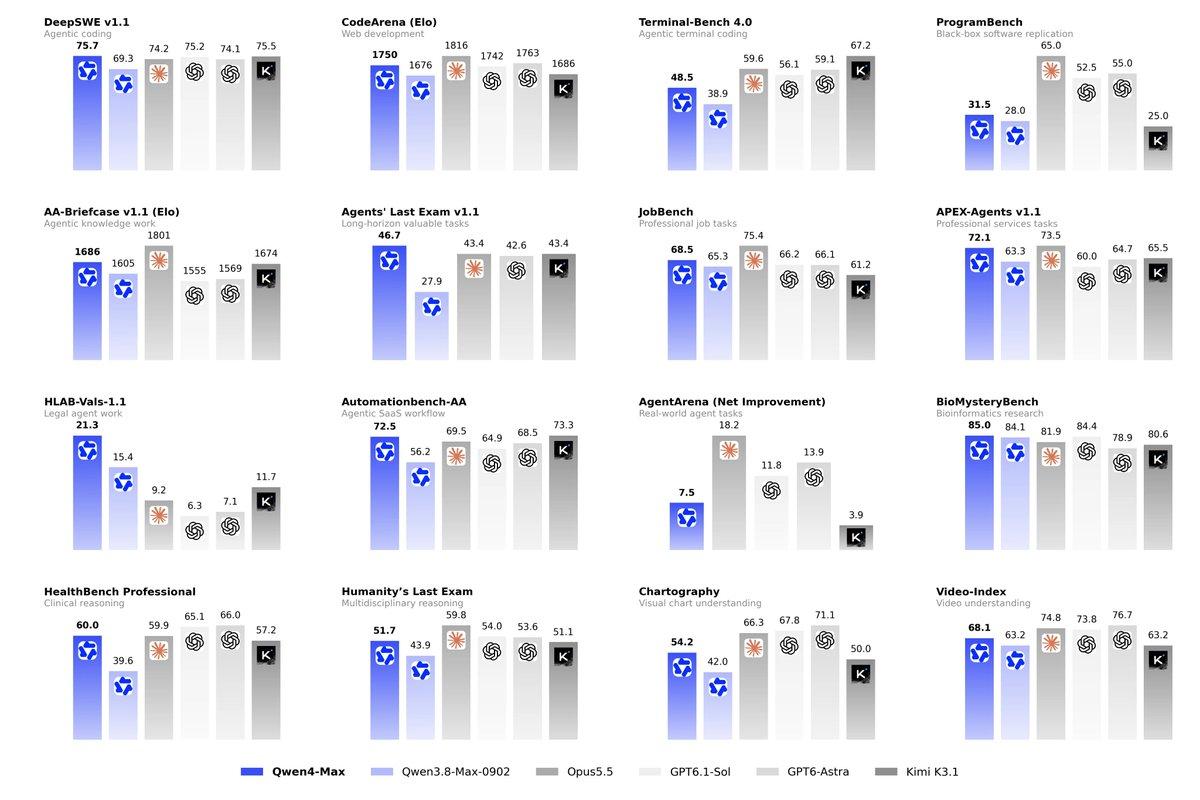
En la tabla de resultados que Alibaba publicó con el lanzamiento, Qwen4-Max se compara con Opus 5.5 de Anthropic, GPT-6.1 Sol y GPT-6 Astra de OpenAI y Kimi K3.1 de Moonshot. Queda por delante de Opus 5.5 en varias pruebas de agentes: 75,7 frente a 74,2 en DeepSWE, de programación con agentes; 46,7 frente a 43,4 en Agents' Last Exam, de tareas largas y valiosas, y 85,0 frente a 81,9 en BioMysteryBench, de investigación bioinformática. En una prueba de agentes jurídicos, HLAB-Vals, saca 21,3 frente a 9,2 de Opus 5.5.
También enseña dónde queda trabajo por hacer. En Terminal-Bench 4.0, que mide agentes de programación trabajando en la línea de comandos, Qwen4-Max saca 48,5 frente a 59,6 de Opus 5.5 y 67,2 de Kimi K3.1. En Humanity's Last Exam obtiene 51,7 frente a 59,8 de Opus 5.5, y en Code Arena, una clasificación pública de programación real, Alibaba dice que es sexto.
Una primera lectura independiente apunta en la misma dirección: Artificial Analysis le dio un 43 en su Intelligence Index, por encima de la mediana de 41 de los modelos comparables. La prueba más reveladora quizá sea lo que Alibaba dice que ya ha hecho con él.
De 475 minutos a 24, y los modelos abiertos que están por llegar
El anuncio de Alibaba enumera los trabajos que ha encargado a Qwen4-Max. En la fabricación de coches, dice que el modelo redujo el tiempo de programar a mano una pieza de unos 475 minutos a 24. En una ejecución de 48 horas de un agente sin supervisión, produjo una molécula refrigerante que después se validó en experimentos. En la propia nube de Alibaba, hizo más de 14 veces más rápida la reprogramación de CPU fuera de línea.
El modelo ya está disponible a través de la API de QwenCloud y de sus suscripciones Token Plan, en la app QwenWork y en Qwen Studio. Sus pesos no son públicos: Qwen4-Max solo funciona en los servidores de Alibaba. La empresa ha prometido que los miembros más pequeños de la familia llegarán en abierto.
“Los modelos de pesos abiertos y menor tamaño de la serie Qwen4 se publicarán pronto para desarrolladores de todo el mundo.”— Alibaba
Para una startup que tiene agentes funcionando día y noche, las cuentas cambian hoy: un modelo con una memoria de un millón de tokens, a 1,50 $ por millón de tokens, que termina más parte del trabajo con menos palabras.
Lo que dice la gente

“📢 Meet Qwen4-Max, your new AI teammate for work, creativity, and discovery! Qwen4-Max is built on a new MoE architecture with native vision and a 1M-token context window. Highlights: - Outperforms Qwen3.8-Max with up to ~50% fewer tokens, while average cost per task drops over”
Neck and Neck With Opus 5.5
The Brief
Mantén la curiosidad
IA y tecnología: qué cambia y por qué importa.
Tu selección diaria, en inglés o español.
Gratis para siempre. Cancela cuando quieras.
Más historias
Conversación
Inicia la conversación