
 The Specialty News
Inkling 2 Mini, de Thinking Machines, tient dans 20 Go et tourne sur un portable
Le laboratoire de Mira Murati a publié ce modèle de 26,4 milliards de paramètres en poids ouverts, et n'importe quel Mac doté de 32 Go de mémoire peut le faire tourner hors ligne.
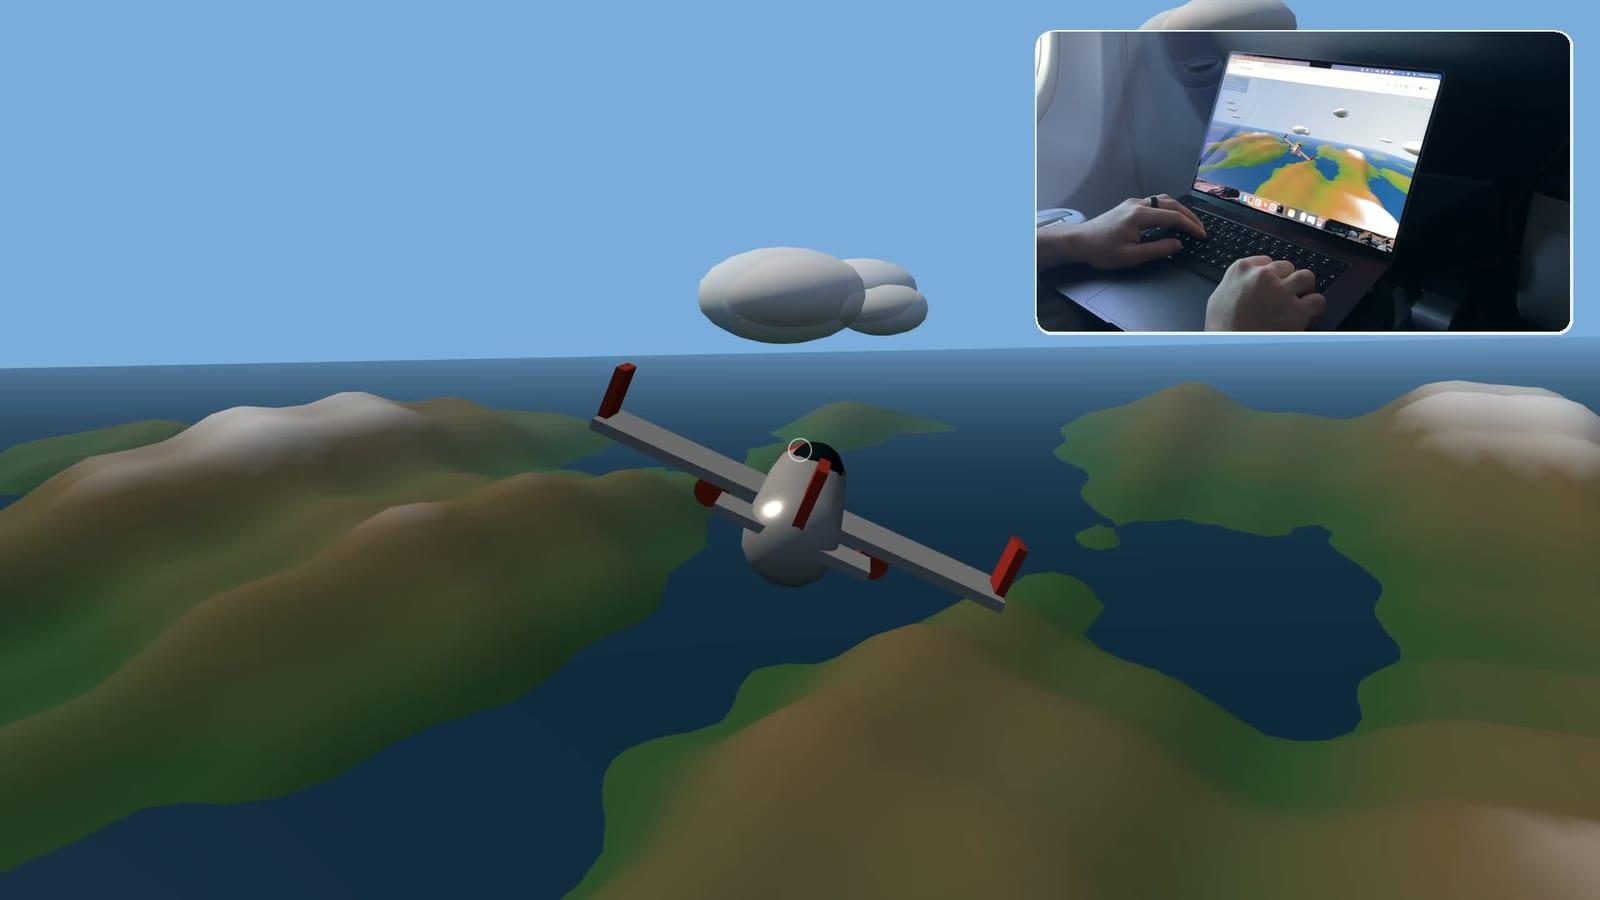
Sur un MacBook Pro en mode avion, sans aucune connexion internet, un nouveau modèle d'IA a écrit un simulateur de vol qui fonctionne. Ce modèle, c'est Inkling 2 Mini, que Thinking Machines Lab a publié vendredi en poids ouverts : 26,4 milliards de paramètres dans environ 20 Go, assez petit pour n'importe quel Mac doté de 32 Go de mémoire. Pour les développeurs qui veulent un vrai assistant de programmation sans envoyer une seule ligne de code dans le cloud, un portable suffit désormais.
Trois tours dans les couches centrales
La plupart des modèles de langage font passer chaque token une seule fois dans leurs couches, de haut en bas. Inkling 2 Mini fait deux tours de plus. Ses 24 couches sont réparties en quatre blocs de six : le premier et le dernier s'exécutent une fois, et les 12 couches du milieu s'exécutent trois fois pour chaque token, si bien que 24 couches stockées font le travail de 48.
L'idée est de réfléchir davantage à l'intérieur du modèle et moins sur la page. Un modèle de raisonnement résout d'ordinaire un problème en écrivant de longues chaînes de texte intermédiaire, et chacun de ces tokens coûte du temps et de la mémoire. La boucle transfère une partie de ce travail vers les passes supplémentaires.
“La boucle permet à un modèle de réfléchir davantage et d'écrire moins.”— Mira Murati
Le laboratoire a introduit les boucles progressivement pendant l'entraînement grâce à une porte apprise, et chaque passe lit un court message laissé par la précédente. Le plus difficile restait de ramener un modèle aussi capable à la taille d'un portable.
De 594 milliards de paramètres à 26,4 milliards
Plus tôt ce mois-ci, Thinking Machines a publié Inkling 2 Small, avec 594 milliards de paramètres. « Certains d'entre vous trouvaient Inkling 2 Small trop gros avec 594B de paramètres », a écrit le laboratoire sur X. Mini est la réponse.
Il part de la famille principale de modèles du laboratoire. L'équipe a élagué deux tiers des experts, en gardant les 128 plus utilisés dans chaque couche sur 384, puis a rétabli le modèle avec 1 000 milliards de tokens distillés d'un Inkling interne plus grand, suivis de 2 200 milliards de tokens d'apprentissage par renforcement.
La taille tient autant à la précision qu'à l'élagage. La plupart des poids ont été entraînés et tournent nativement en NVFP4, un format numérique sur 4 bits, avec les quatre dernières couches en MXFP8. Comme le modèle n'a jamais besoin d'être compressé après l'entraînement, rien ne se perd à la conversion.
Le tout tourne sur un MacBook ou un Mac Mini doté d'au moins 32 Go de RAM via Ollama, et sur l'ordinateur de bureau DGX Spark de Nvidia. Et une fois installé, que sait-il faire ?
Un simulateur de vol construit en mode avion
Selon les tests du laboratoire, Inkling 2 Mini obtient 48,2 % sur DeepSWE, un banc d'essai de vraies tâches d'ingénierie logicielle, contre 42,2 % pour Qwen3.8-27B d'Alibaba, et 79,2 % sur SWE-bench Verified. Sur l'Intelligence Index d'Artificial Analysis, il fait jeu égal avec Qwen3.8-27B à 20,1, et Artificial Analysis a mesuré chacune de ses tâches à 0,59 dollar et 9 minutes, contre 3,53 dollars et 38,2 minutes pour Qwen.
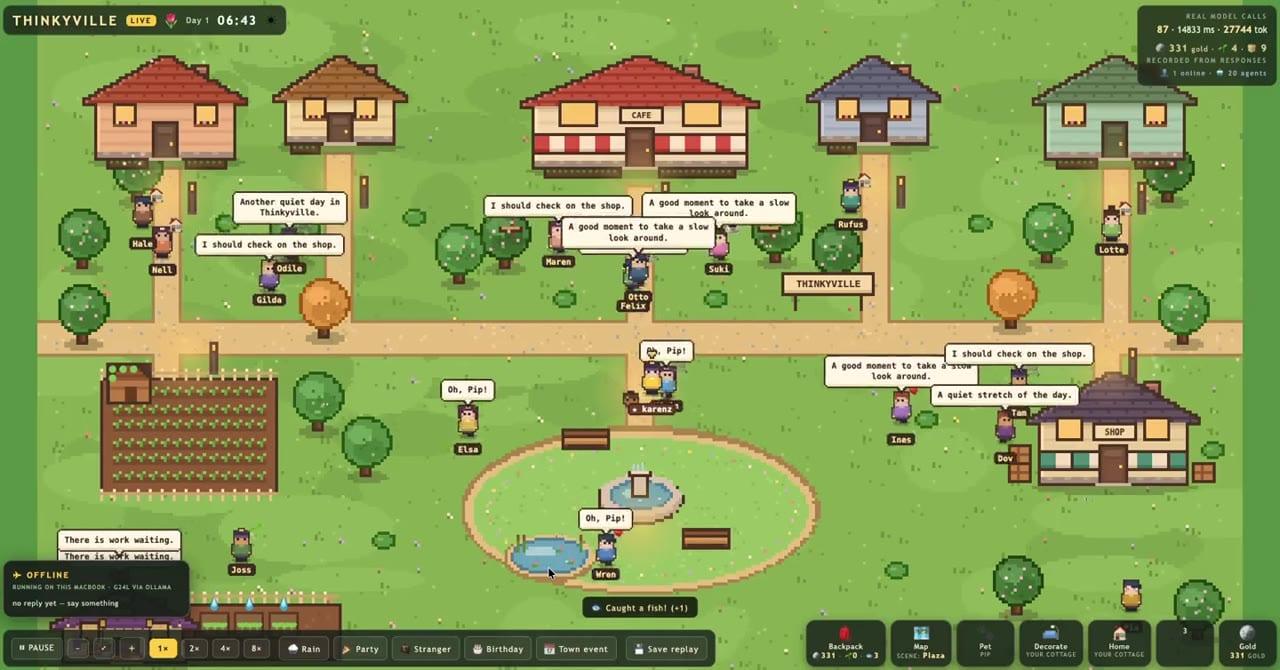
Des chercheurs de Stanford qui l'ont fait tourner sur un DGX Spark lui ont attribué 0,703 sur leur mesure d'intelligence par watt, contre 0,430 pour Qwen3.6-35B-A3B. Dans une autre démonstration du laboratoire, un seul MacBook hors ligne animait Thinkyville, un village en pixel art de 20 habitants, chacun piloté par le modèle.
Les poids sont sur Hugging Face sous licence Apache 2.0, avec une fenêtre de contexte allant jusqu'à 1 million de tokens, et le modèle est disponible sur Tinker, le service du laboratoire pour faire tourner et affiner des modèles. Un hôpital qui ne peut pas envoyer de dossiers médicaux dans le cloud et un développeur sur un long vol disposent désormais de la même option.
Un modèle ouvert de programmation de premier plan tient désormais dans 20 gigaoctets, et il fonctionne Wi-Fi coupé.
Same Index Score, 6x Cheaper
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles
Conversation
Lancer la conversation