
 The Specialty News
Le processeur Jalapeño d'OpenAI brise le monopole matériel de Nvidia
Avec un débit 1,9x supérieur pour une consommation d'énergie réduite de moitié par rapport à un GPU Blackwell, cette nouvelle puce sur mesure vise à réduire la facture de serveurs de ChatGPT, qui s'envole à $14 milliards.
OpenAI a dépensé $8,4 milliards l'an dernier juste pour faire fonctionner ChatGPT. Avec 900 millions d'utilisateurs hebdomadaires prévus pour cette année, cette facture opérationnelle grimpe en flèche vers un montant insoutenable de $14 milliards. Pour survivre, la start-up d'IA la plus célèbre au monde a dû faire exactement ce qu'Apple et Google ont fait avant elle: concevoir ses propres puces.
Moitié moins d'énergie, deux fois plus rapide
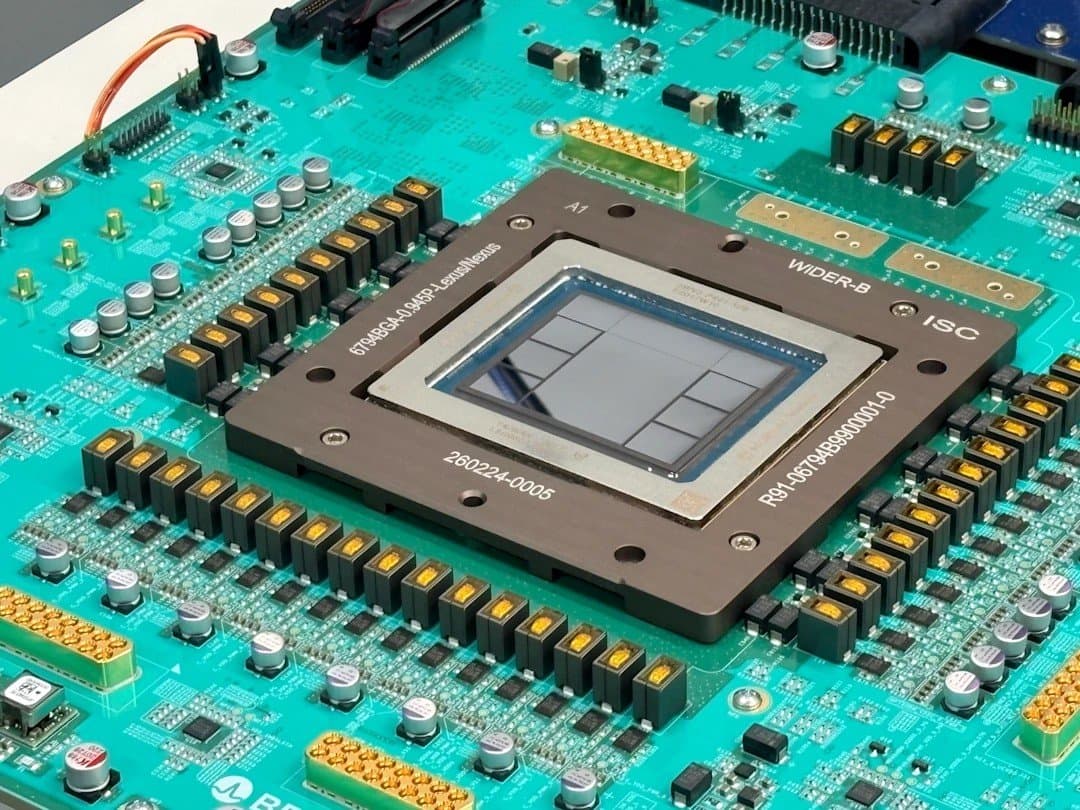
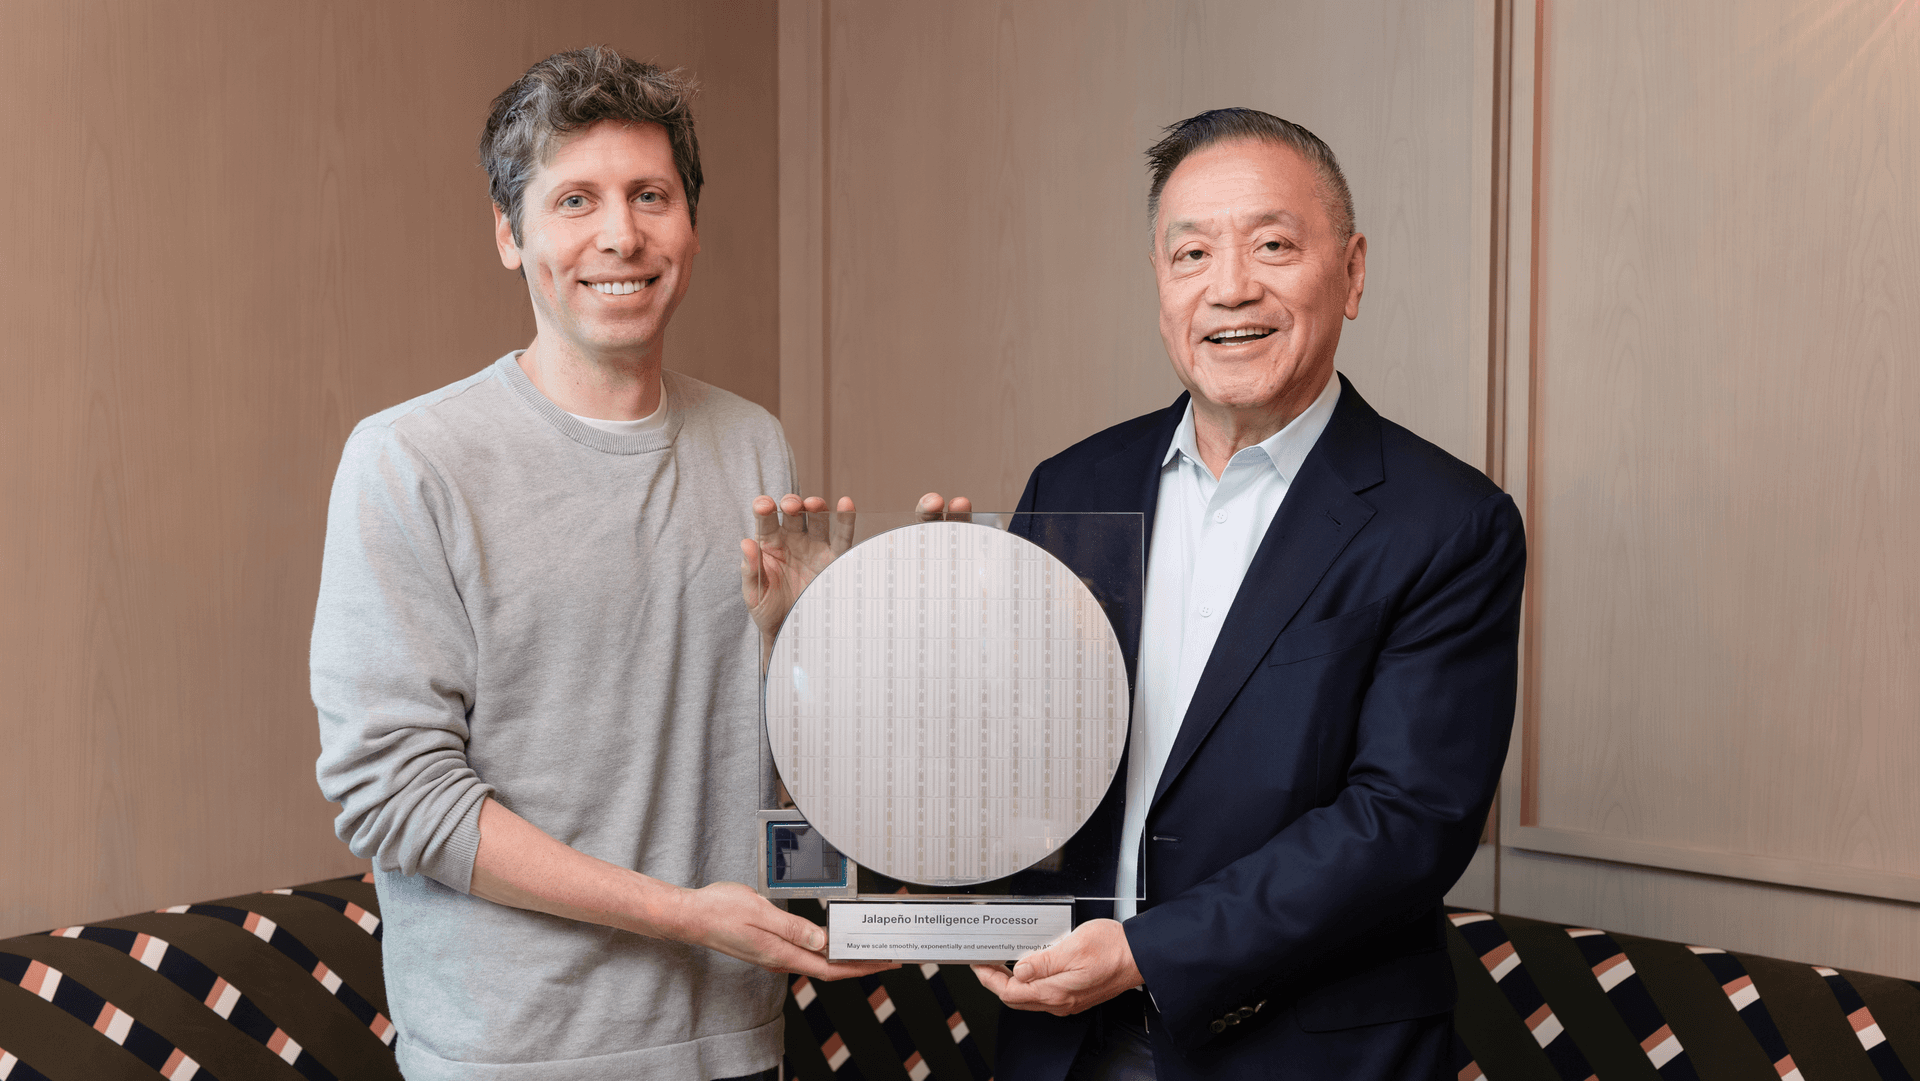
OpenAI a levé le voile sur son premier processeur d'IA sur mesure lors de la conférence Hot Chips 2026. Sous le nom de code Jalapeño, ce circuit intégré propre à une application (ASIC) transforme une rumeur persistante du secteur en une réalité qui pulvérise les benchmarks. Fabriqué sur le procédé de pointe en 3nm de TSMC, il représente une attaque directe contre le goulot d'étranglement fondamental de l'IA moderne: l'électricité.
Lors des tests publics InferenceX, Jalapeño a affiché une latence jusqu'à 3,6x plus faible et un débit par watt presque doublé par rapport aux systèmes phares GB200 et GB300 de Nvidia. Il y est parvenu tout en consommant entre 550W et 700W, soit environ la moitié de l'empreinte énergétique des colosses de 1,400W de Nvidia.
Surtout, la puce ne s'est pas contentée de briller sur les modèles propriétaires d'OpenAI. Les testeurs ont constaté des gains de performance massifs sur des modèles open-weight majeurs comme Kimi K2.5 (1 billion de paramètres) et DeepSeek R1. Grâce à la mémoire HBM4 de nouvelle génération de Samsung offrant une bande passante de 15,4 TB/s, Jalapeño gère les transferts massifs de données qui saturent habituellement les charges de travail d'inférence.
Échapper à la taxe de 75% sur les marges
La motivation derrière Jalapeño est purement financière. Nvidia affiche actuellement des marges bénéficiaires d'environ 75% sur son matériel, un péage que chaque développeur d'IA est contraint de payer. En concevant un ASIC spécifiquement pour l'inférence — le processus consistant à répondre aux requêtes des utilisateurs, plutôt qu'à entraîner le modèle initialement — OpenAI court-circuite l'intermédiaire.
“OpenAI Jalapeño est piquant. D'ordinaire, les puces de première génération ne sont pas compétitives, mais OpenAI bat Nvidia Blackwell et même Rubin.”— Dylan Patel
Pour réussir ce tour de force en seulement 16 mois, OpenAI a débauché Richard Ho, l'ancien responsable du projet Tensor Processing Unit de Google. L'équipe de Ho a collaboré étroitement avec Broadcom pour co-développer l'ingénierie de la puce et l'architecture réseau. En adaptant le matériel directement aux schémas de transfert de mémoire de leur propre suite logicielle, ils ont éliminé les inefficacités inhérentes aux puces génériques du marché.
L'épreuve de réalité du gigawatt
Briller sur des benchmarks publics avec une petite baie de test est impressionnant, mais faire fonctionner sans faille un centre de données de plusieurs gigawatts est un tout autre sport. Les analystes de la tech agitent déjà des drapeaux rouges quant aux réalités du déploiement d'une puce de première génération à l'échelle mondiale.
La chaîne d'approvisionnement présente un défi tout aussi redoutable. En s'appuyant sur les nœuds de gravure en 3nm de TSMC et la mémoire HBM4 de Samsung, OpenAI s'aventure sur un terrain extrêmement disputé. L'entreprise rivalise désormais directement pour les capacités de production face à des géants comme Apple, AMD et Nvidia elle-même.
De plus, Nvidia ne reste pas les bras croisés. Le géant du matériel livre déjà son architecture de nouvelle génération «Vera Rubin». OpenAI a pris soin de préciser qu'elle considère toujours Nvidia comme un partenaire essentiel pour les tâches d'entraînement de nouveaux modèles, très gourmandes en calcul, préservant ainsi une passerelle vitale.
Le moment «Apple Silicon» de l'IA
Jalapeño valide la thèse de l'«Apple Silicon» pour l'ère de l'intelligence artificielle. Lorsque l'équipe qui conçoit les algorithmes logiciels travaille juste en face des ingénieurs qui conçoivent le matériel, l'intégration verticale qui en résulte libère des performances que les systèmes modulaires ne peuvent tout simplement pas égaler.
Cette percée ouvre la voie à une nouvelle génération d'agents autonomes ultra-rapides et extrêmement performants. Une latence plus faible et un coût de calcul réduit signifient que les modèles d'IA peuvent «penser» à voix haute, corriger leurs propres erreurs et exécuter des flux de travail complexes en temps réel sans ruiner leurs créateurs.
L'époque où l'on considérait les entreprises d'IA uniquement comme des éditeurs de logiciels est révolue. Pour façonner l'avenir de l'intelligence artificielle, il faut désormais concevoir son propre silicium.
Ce que les gens en disent

“OPENAI’S JALAPENO CHIP OUTPACES NVIDIA IN TESTS OpenAI says its new Jalapeno AI chip beat Nvidia’s GB300 in power efficiency and response speed during testing. Developed with Broadcom, Jalapeno targets AI inference and could lower data-center costs while handling large models.”

“OpenAI just published the first detailed numbers for Jalapeño. The custom inference ASIC, co-designed with Broadcom, is built specifically for large-language-model serving rather than training. On the InferenceX benchmark suite it delivered 1.5–1.9× more AI work per watt at”

“OpenAI 第一代自研芯片(Jalapeño)推理效率就打赢了 Nvidia Blackwell,连 Rubin 也落败。 这不是硬件新闻,是护城河公告。 Nvidia 的 GPU 任何人都能买。Jalapeño 只属于 OpenAI 一家。 效率越高,锁定越深: — 推理成本内化 → 利润更厚 — 吞吐量领先 → 难以复制 —”
Jalapeño vs Nvidia Blackwell
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles



Conversation
Lancer la conversation