
 The Specialty News
OpenAI lance la puce d'inférence Jalapeño pour briser le monopole de Nvidia dans l'IA
Co-développé avec Broadcom en seulement neuf mois, cet ASIC gravé en 3 nanomètres réduit considérablement la consommation d'énergie tout en offrant un gain de performance massif pour les tâches agentiques.
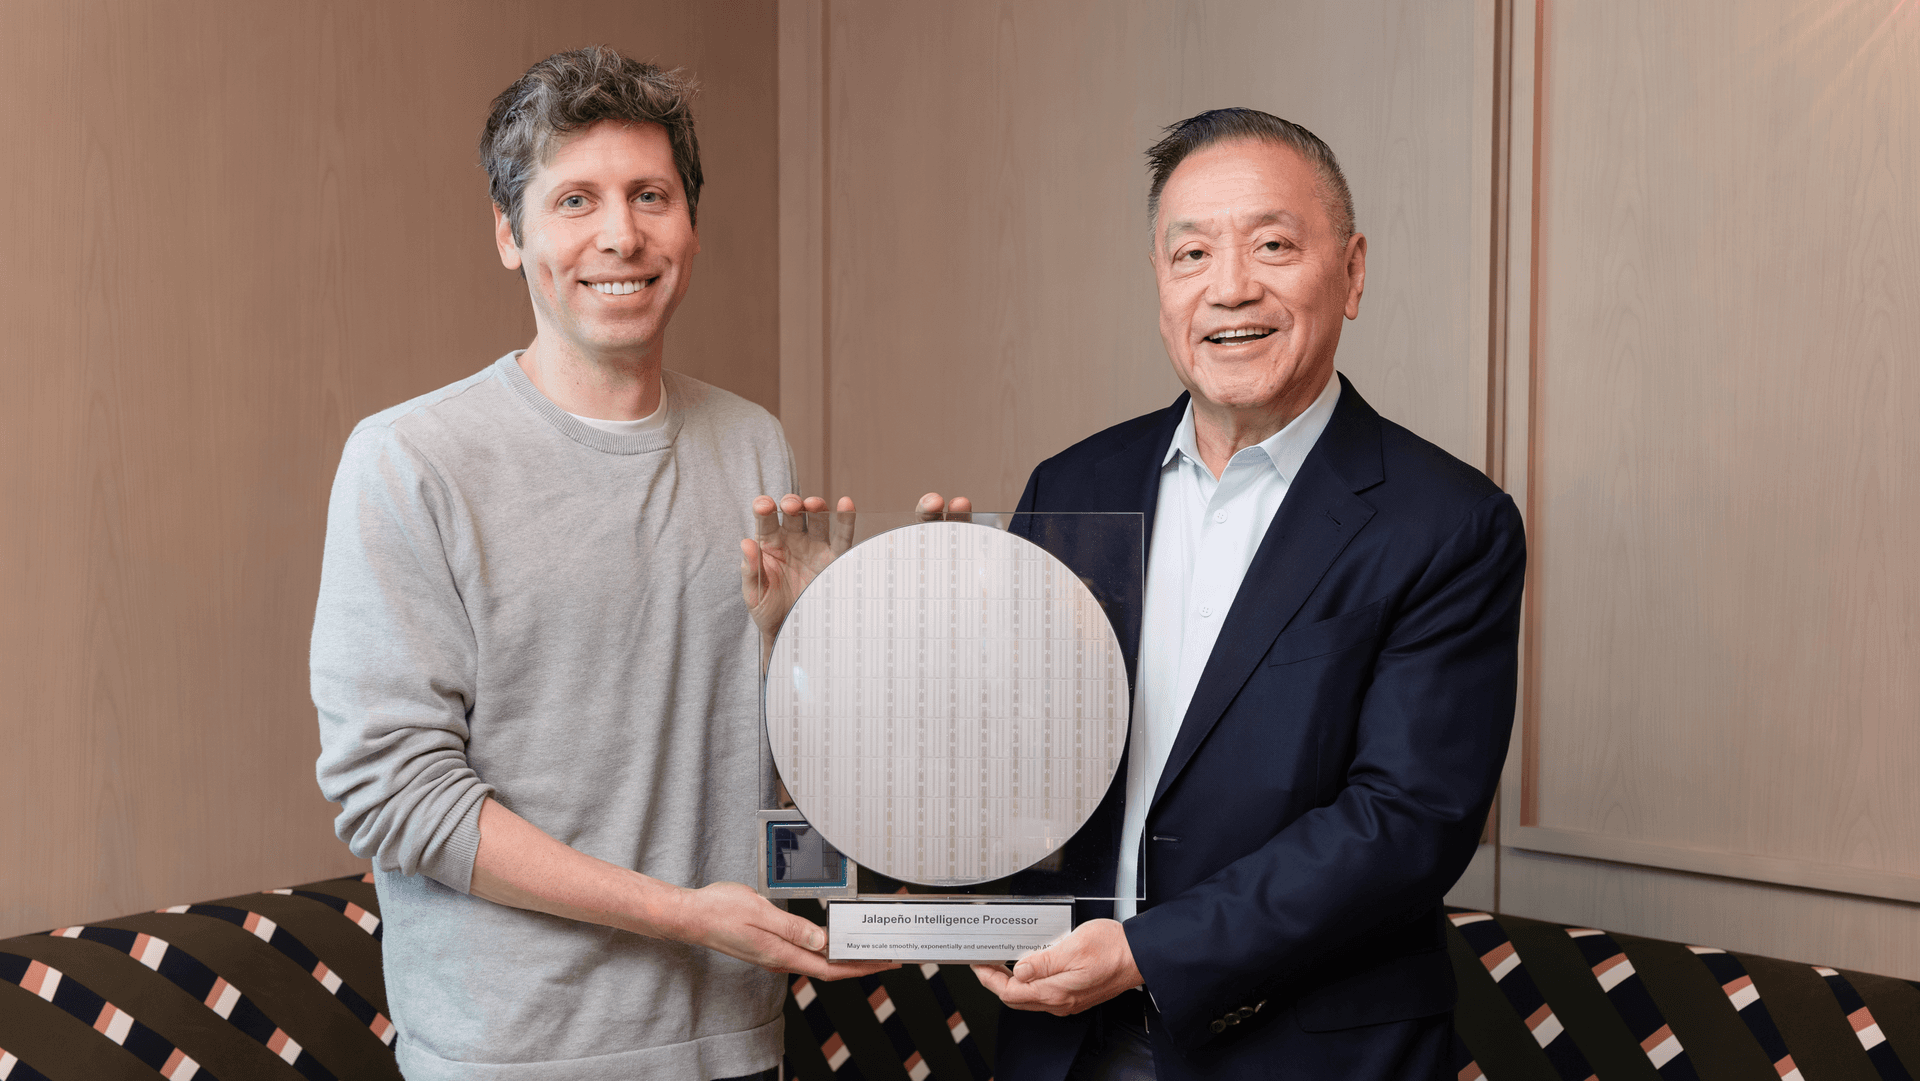
Le développement de matériel informatique est réputé pour sa lenteur, se mesurant en années et en dépenses d'investissement massives. OpenAI vient de balayer ce modèle établi. Le 25 août, le poids lourd de l'IA a officiellement fait son entrée dans le secteur des puces avec « Jalapeño », un circuit intégré propre à une application (ASIC) conçu sur mesure et co-développé avec Broadcom, dont la concrétisation n'a pris que neuf mois à partir du tape-out.
La fin du compromis entre débit et latence
Traditionnellement, l'architecture des puces impose un choix cornélien : soit optimiser le débit pour traiter des volumes massifs de données, soit optimiser la latence pour fournir des réponses individuelles ultra-rapides. La conception sur mesure de Jalapeño brise ce compromis. Gravée grâce au procédé de pointe en 3 nanomètres de TSMC, elle intègre une mémoire HBM4 ultra-rapide offrant une bande passante de 15,4TB/s par boîtier.
Ce qui rend cette prouesse véritablement remarquable, c'est la faible quantité d'énergie requise pour atteindre de telles performances. Jalapeño fonctionne avec une enveloppe thermique (TDP) de seulement 700 watts. À titre de comparaison, les dernières puces Rubin de Nvidia consomment entre 900 et 1 150 watts. Selon la suite de tests indépendante InferenceX, la puce d'OpenAI réalise 1,5 à 1,9 fois plus de calculs d'IA par watt que les systèmes commerciaux comparables.
Cette efficacité est précisément ce qui permet d'exécuter des raisonnements complexes et continus (chain-of-thought) sans ruiner les développeurs. Hock Tan, PDG de Broadcom, a souligné que les premiers tests en laboratoire indiquent que les coûts d'exploitation de Jalapeño pourraient être inférieurs d'environ 50% à ceux des GPU d'IA classiques pour des charges de travail types.
Des machines qui conçoivent des machines
La surprise de la communauté technologique ne vient pas seulement des benchmarks, mais aussi de ce calendrier sans précédent. Un cycle de 16 mois entre la formation de l'équipe et le tape-out de fabrication est pratiquement du jamais vu dans l'ingénierie moderne des semi-conducteurs. OpenAI a réussi à tenir ce calendrier impossible en déployant ses propres modèles de pointe pour co-concevoir l'architecture.
Le plus grand obstacle pour toute nouvelle puce reste la suite logicielle. La plateforme CUDA de Nvidia est extrêmement bien ancrée, agissant comme un véritable fossé défensif face aux concurrents. OpenAI est parti de zéro mais a surmonté cet obstacle en confiant à son IA la traduction et l'optimisation du code nécessaire à l'architecture unique de Jalapeño.
“Le monde évolue vers une économie alimentée par la puissance de calcul. Jalapeño s'inscrit dans notre stratégie d'infrastructure globale à long terme visant à rendre le calcul plus abondant.”— Greg Brockman
Il est intéressant de noter que ce matériel n'est pas verrouillé dans un écosystème fermé. Bien que conçue en interne, Jalapeño a obtenu des performances de premier ordre sur des modèles open source massifs tels que DeepSeek R1 et Kimi K2.5, prouvant ainsi sa viabilité en tant que moteur d'inférence hautement polyvalent.
Ce que les gens en disent

“The real breakthrough in the NVIDIA SANA team’s Sol Engine work on MiniMax H3! By splitting generation into a 4-step low-res H3 draft and a 3-step LTX refinement pass at target resolution with Sol-Attn, they’ve crushed 10s 768p latency on a single GB200 from 414s down to 14.93s”

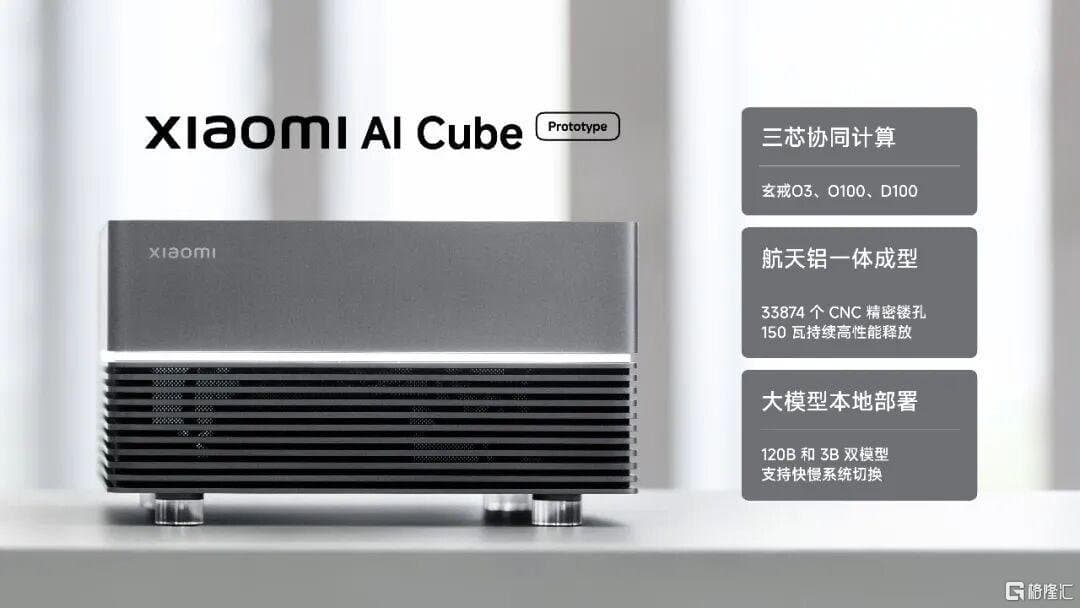
“Xiaomi just showed its AI Cube Prototype and this could become a serious GB10 competitor from China 👀 - 3 custom chips: Xring O3, O100, D100 - 200 TOPS NPU - 1.22 TB/s AI memory bandwidth - Up to 160GB unified memory - 150W sustained power - 120B models running locally Xring”

“The first CPU built for agents is now at work at massive scale. @SpaceXAI is deploying NVIDIA Vera to power agentic AI — faster agents, GPUs fully utilized, and a single architecture from Earth to orbit. Read more ⬇️”
OpenAI Jalapeño vs Nvidia
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles



Conversation
Lancer la conversation