
 The Specialty News
Google donne une télécommande à Gemini, et les coûts de la vidéo par IA s'effondrent de 88%
En transformant les modèles de sténographes passifs en enquêteurs actifs, DeepMind vient de résoudre le plus grand goulot d'étranglement de l'informatique multimodale.
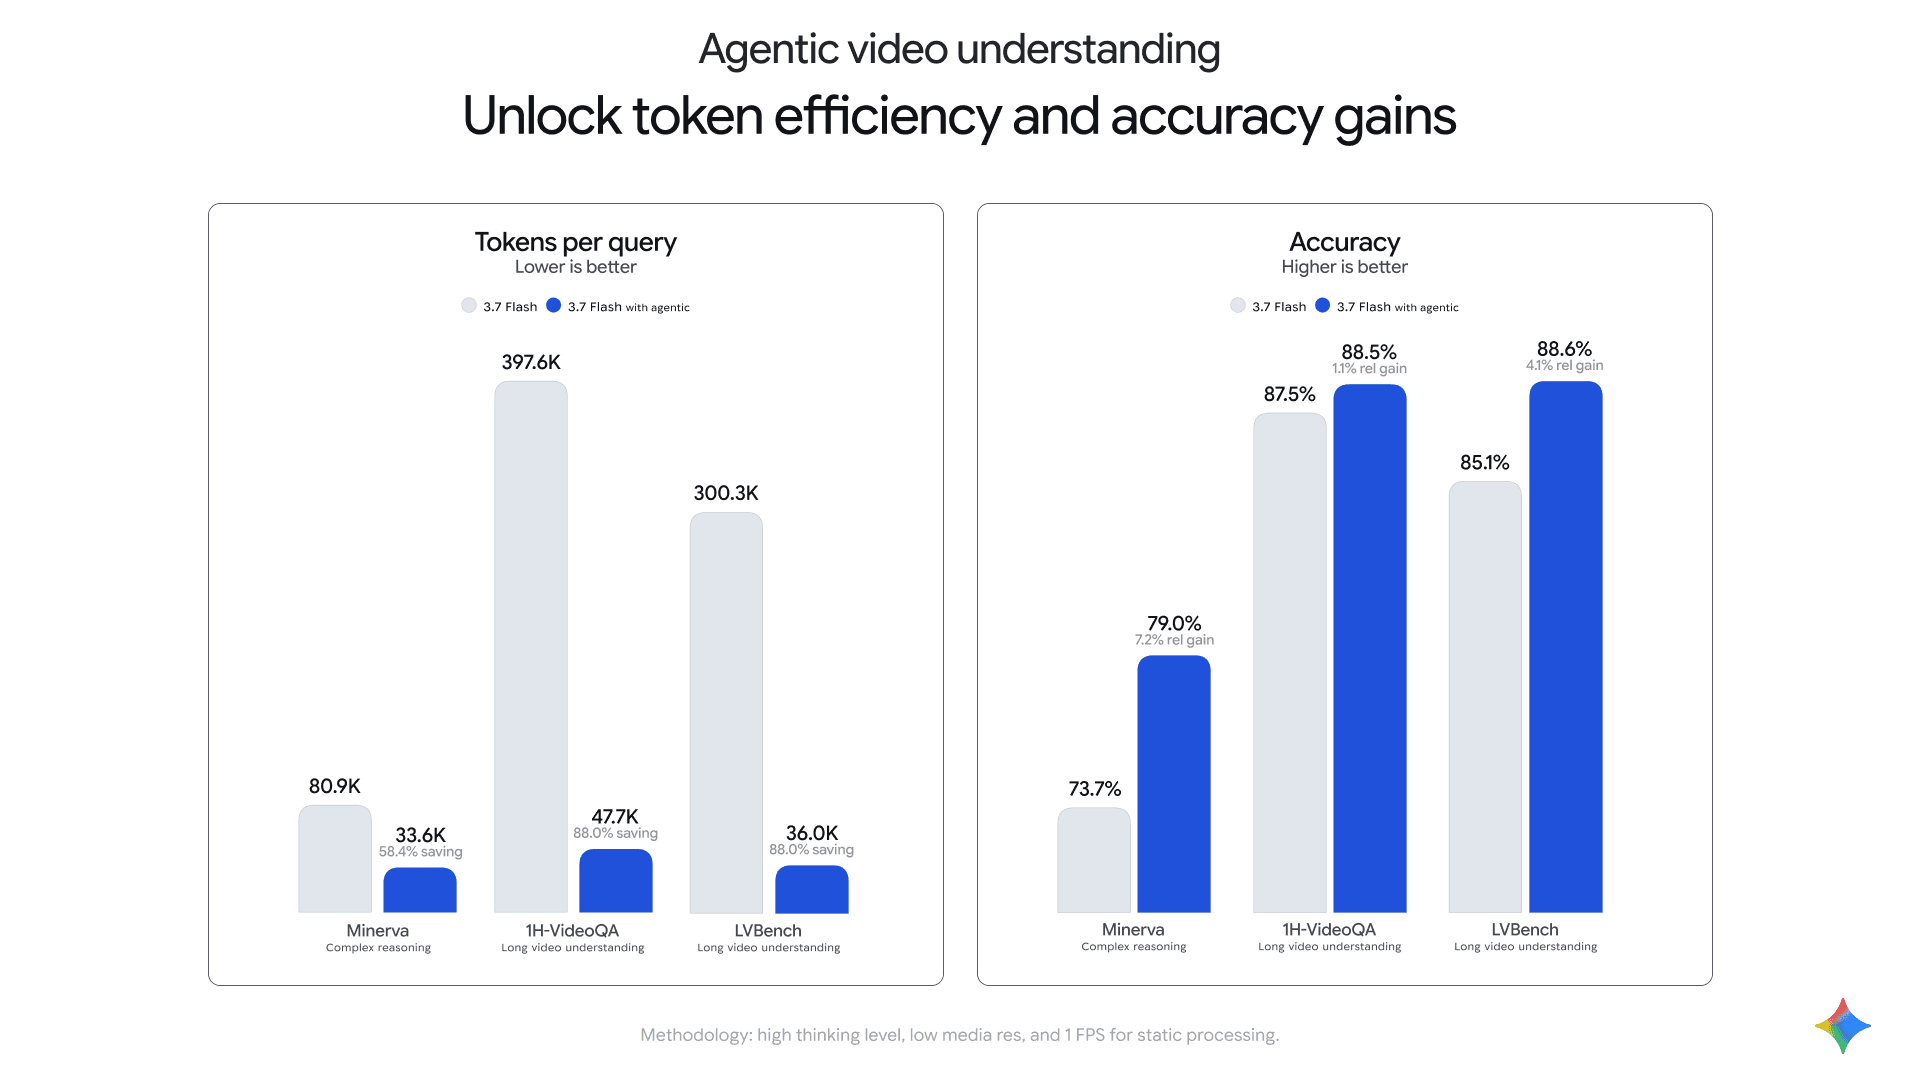
Confiez une vidéo à un modèle d'IA traditionnel, et il se comportera comme un otage ligoté à une chaise, forcé de regarder chaque image, à raison d'exactement une image par seconde. Google DeepMind vient de couper les liens. Grâce à une nouvelle mise à jour de ses modèles Gemini, l'IA fonctionne désormais comme un enquêteur humain armé d'une télécommande: elle parcourt d'abord la transcription, passe en avance rapide sur les temps morts à 0.1 image par seconde, et ralentit pour capturer les actions rapides. Il s'agit d'un changement fondamental dans la manière dont les machines traitent la réalité, transformant l'analyse vidéo d'un luxe au coût prohibitif en un standard accessible.
Le péage des 100,000 tokens
Hier encore, soumettre l'enregistrement d'une réunion de 60 minutes à un modèle multimodal signifiait lui faire avaler 3,600 images individuelles et consommer plus de 100,000 tokens. C'était une approche par force brute. Pour répondre à une question simple sur ce que le PDG avait dit à la 42e minute, l'IA devait payer le péage informatique des 59 autres minutes de raclements de gorge et de partages d'écran.
En passant un simple paramètre d'API sur « agentic », les développeurs font désormais basculer le modèle d'un état passif à un état actif. Au lieu d'ingérer l'intégralité du fichier vidéo à un rythme fixe, Gemini exécute une boucle interne pour réfléchir, agir et observer. Il lit la transcription comme une carte, se positionne sur la séquence précise de 10 secondes dont il a réellement besoin, et n'active la piste audio que si les indices acoustiques sont importants.
C'est l'équivalent informatique de la lecture de l'index d'un livre plutôt que de sa lecture intégrale simplement pour y trouver un nom. Le modèle échappe au bruit, ce qui augmente la précision de 7% précisément parce qu'il ne se noie pas dans des données non pertinentes. Mais cette efficacité chirurgicale ne se contente pas d'améliorer les résultats des tests: elle bouleverse l'économie sous-jacente de l'industrie de l'IA.
Saborder le marché des middlewares
Depuis un an, le traitement des contenus longs était le goulot d'étranglement ultime. Il bloquait l'accès des petits créateurs à l'analyse vidéo complexe, piégeant les outils de RAG vidéo et les plateformes d'analyse sportive automatisée au stade de prototypes. Le coût prohibitif des tokens obligeait les développeurs à s'en remettre à un écosystème de startups qui concevaient des middlewares de compression propriétaires pour élaguer les vidéos avant que l'IA ne les analyse.
“Plutôt que de dépenser 200k tokens pour traiter une longue vidéo, Gemini peut désormais utiliser des outils pour les traiter intelligemment en fonction de la consigne... ce qui permet de réduire les tokens de 88%.”— Omar Sanseviero
Google vient d'intégrer directement l'ensemble de cette industrie du middleware dans son API de base. En faisant du raisonnement agentique une fonctionnalité native, des architectes comme Rohan Doshi et Mario Lučić de DeepMind simplifient radicalement la pile technologique.
Les startups qui pariaient sur le maintien de coûts élevés pour les tokens deviennent soudainement obsolètes, tandis que les développeurs indépendants qui conçoivent la prochaine génération d'agents de transcription bénéficient d'une augmentation massive de leurs marges. Pourtant, malgré toute son élégance structurelle, confier la télécommande à une IA introduit un nouveau type de risque.
Le piège de TikTok
Cette efficacité spectaculaire est un scénario idéal tiré de tests de référence où des heures de vidéo sont en réalité sans rapport avec la requête. Si vous confiez à Gemini un clip TikTok dense de 30 secondes où chaque image regorge d'indices visuels, il n'y a aucun temps mort à ignorer.
En fait, Google conseille discrètement aux développeurs de conserver le traitement statique activé pour les clips de moins de quelques minutes. La surcharge de calcul requise pour lancer la boucle agentique peut en réalité ralentir les temps de réponse pour les requêtes rapides. Les sceptiques soulignent également la crainte persistante d'une boucle défaillante, se demandant si un modèle ne risquerait pas de décider à tort de passer en avance rapide sur un indice visuel crucial mais silencieux, simplement parce qu'il n'a pas été signalé au préalable dans la transcription.
DeepMind n'attend pas que l'industrie tranche le débat. Dans les mois à venir, ce même moteur agentique alimentera une fonctionnalité « Ask YouTube » directement sur les pages de visionnage, apportant une analyse vidéo chirurgicale à des milliards d'utilisateurs. Nous avons passé les deux dernières années à apprendre à l'IA à regarder des vidéos. Désormais, nous lui apprenons ce qu'elle doit ignorer.
Ce que les gens en disent

“We’re introducing a new capability to our latest Gemini models: agentic video understanding. This allows developers to process long-form video content with more accuracy, while using up to 88% less tokens. See how it works 🧵”

“introducing agentic video understanding with Gemini instead of using static processing (ingesting media at a fixed frame rate), the model can now take an active, goal-directed role in determining what to watch, at what speed, and through which modality (frames, audio, or”

“Meet Gemini Omni 1.1 Flash ⚡️ Our newest multimodal model for video generation and editing. It now features your favorite creative controls from Veo, plus brand new capabilities. Enjoy features like 4K upscaling, first / last frame control, and fast 360p drafting. But, the”
Passive vs Agentic Video AI
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles



Conversation
Lancer la conversation