
 The Specialty News
Google le da un control remoto a Gemini y los costos de video con IA se desploman un 88%
Al transformar los modelos de taquígrafos pasivos en investigadores activos, DeepMind acaba de resolver el mayor cuello de botella de la computación multimodal.
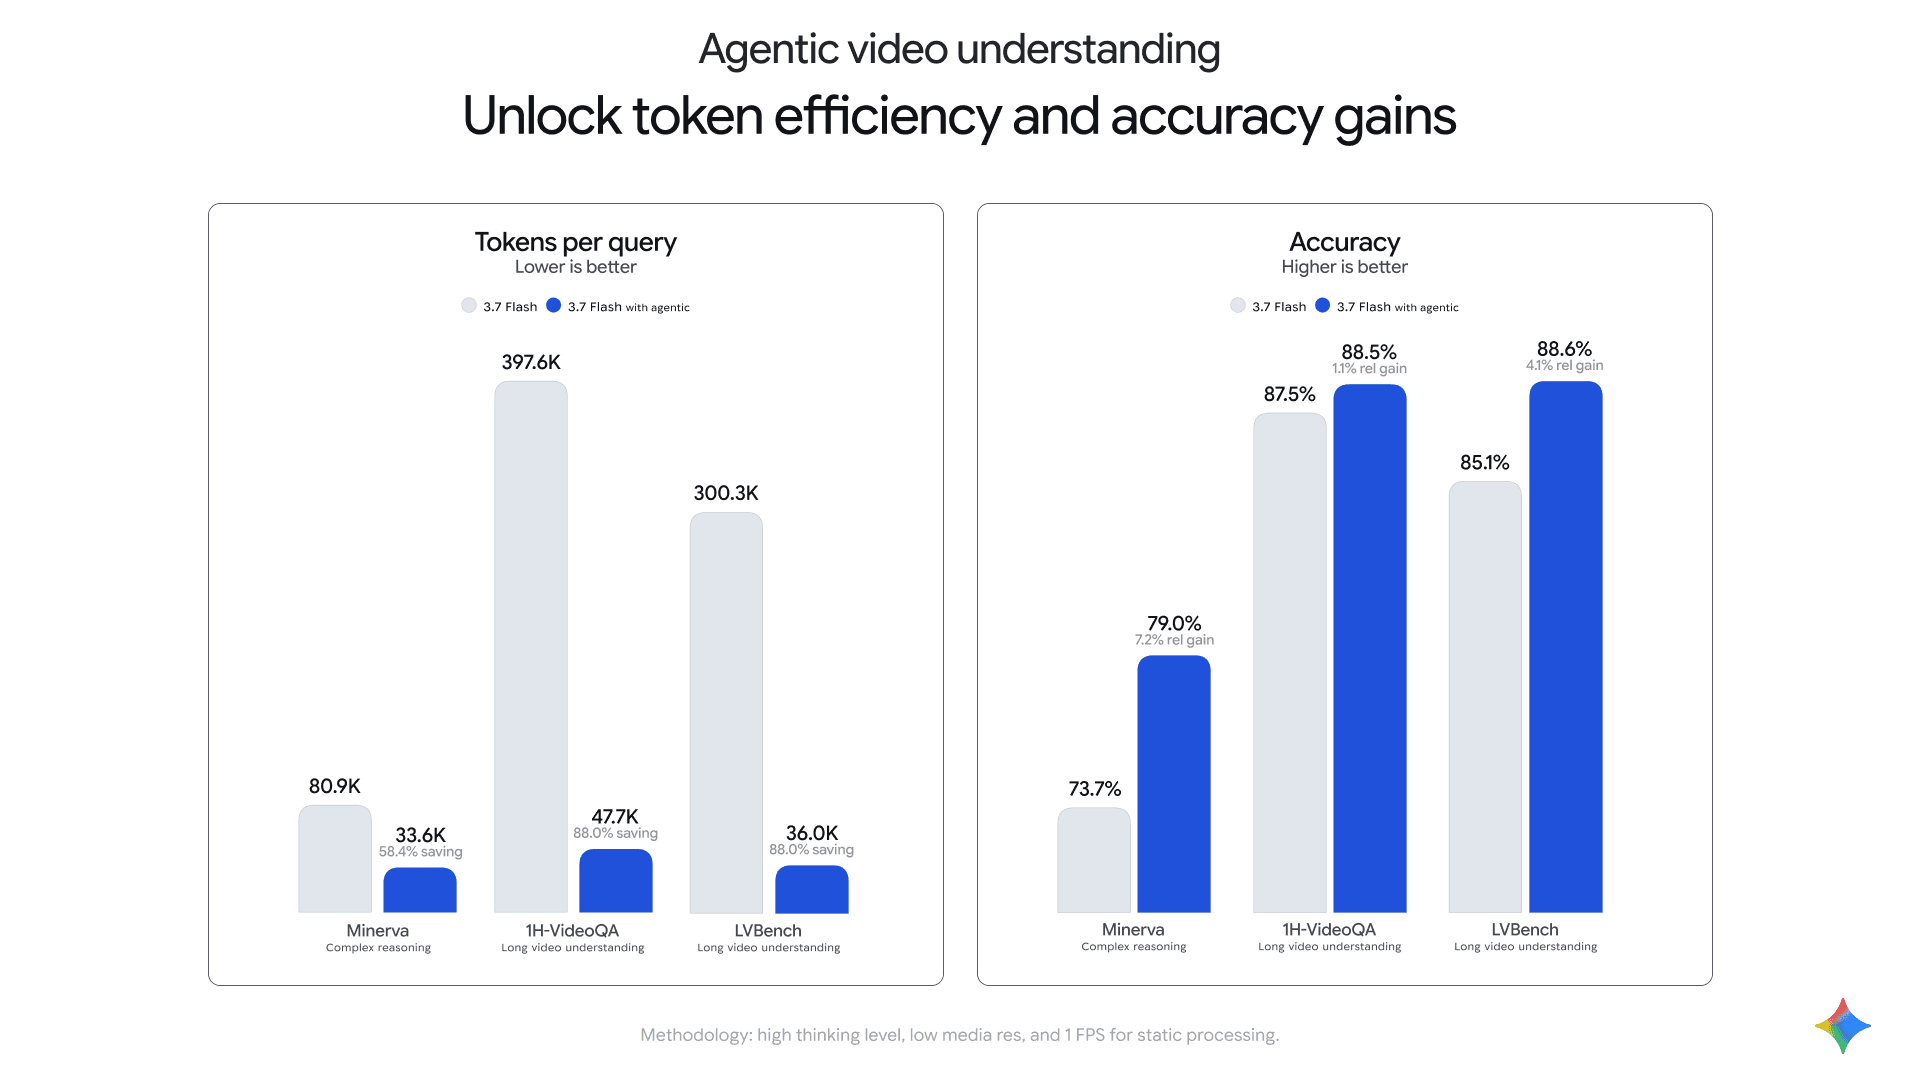
Entrégale un video a un modelo de IA tradicional y actuará como un rehén atado a una silla, obligado a ver cada fotograma a exactamente un segundo por fotograma. Google DeepMind acaba de cortar las cuerdas. Con una nueva actualización en sus modelos Gemini, la IA ahora opera como un investigador humano armado con un control remoto: escanea primero la transcripción, avanza rápido por los tiempos muertos a 0.1 fotogramas por segundo y desacelera para captar la acción rápida. Es un cambio fundamental en la forma en que las máquinas procesan la realidad, transformando el análisis de video de un lujo de costo prohibitivo en una opción predeterminada y accesible.
El peaje de los 100,000 tokens
Ayer, introducir la grabación de una reunión de 60 minutos en un modelo multimodal significaba tragar 3,600 fotogramas individuales y consumir más de 100,000 tokens. Era un enfoque de fuerza bruta. Para responder a una pregunta sencilla sobre lo que dijo el CEO en el minuto 42, la IA tenía que pagar el peaje computacional por los otros 59 minutos de aclaraciones de garganta y pantallas compartidas.
Al cambiar un solo parámetro de la API a "agéntico", los desarrolladores ahora transforman el modelo de pasivo a activo. En lugar de ingerir todo el archivo de video a una velocidad fija, Gemini ejecuta un bucle interno para pensar, actuar y observar. Lee la transcripción como un mapa, se desplaza hasta el fragmento preciso de 10 segundos que realmente necesita y solo activa la pista de audio si las señales acústicas importan.
Es el equivalente computacional a leer el índice de un libro en lugar de leerlo de portada a portada solo para encontrar un nombre. El modelo escapa del ruido, aumentando la precisión en un 7% precisamente porque no se está ahogando en datos irrelevantes. Pero esta eficiencia quirúrgica no solo mejora los resultados de las pruebas: cambia por completo la economía subyacente de la industria de la IA.
Hundiendo el mercado del middleware
Durante el último año, el procesamiento de medios de larga duración fue el cuello de botella definitivo. Dejó fuera a los desarrolladores más pequeños del análisis de video complejo, atrapando a las herramientas de video-RAG y a las plataformas automatizadas de análisis deportivo en la fase de prototipo. El costo prohibitivo de los tokens obligó a los creadores a depender de una industria artesanal de startups que desarrollaban middleware de filtrado propietario para comprimir el video antes de que la IA lo viera.
“En lugar de gastar 200k tokens procesando un video largo, Gemini ahora puede usar herramientas para procesarlos de manera inteligente según la instrucción... lo que resulta en un 88% menos de tokens.”— Omar Sanseviero
Google acaba de integrar toda esa industria de middleware directamente en la API base. Al hacer del razonamiento agéntico una función nativa, arquitectos como Rohan Doshi y Mario Lučić de DeepMind están colapsando la pila tecnológica.
Las startups que apostaban a que los costos de los tokens se mantendrían altos quedan repentinamente obsoletas, mientras que los desarrolladores independientes que construyen la próxima generación de agentes de transcripción acaban de recibir un enorme impulso en sus márgenes. Sin embargo, a pesar de toda su elegancia estructural, entregarle el control remoto a una IA introduce un nuevo tipo de riesgo.
La trampa de TikTok
La eficiencia que acapara los titulares es un escenario ideal extraído de pruebas de rendimiento donde horas de metraje son en realidad irrelevantes para la instrucción. Si le entregas a Gemini un clip denso de TikTok de 30 segundos donde cada fotograma está repleto de señales visuales, no hay tiempo muerto que omitir.
De hecho, Google aconseja discretamente a los desarrolladores mantener activado el procesamiento estático para clips de menos de unos pocos minutos. La sobrecarga computacional requerida para iniciar el bucle agéntico puede, de hecho, ralentizar los tiempos de respuesta para consultas rápidas. Los escépticos también señalan el temor persistente de un "bucle con filtraciones", preguntándose si un modelo podría decidir erróneamente avanzar rápido y pasar por alto una pista visual crucial y silenciosa solo porque no fue marcada primero en la transcripción.
DeepMind no está esperando a que la industria resuelva el debate. En los próximos meses, este mismo motor agéntico impulsará una función "Ask YouTube" directamente en las páginas de reproducción, llevando el análisis quirúrgico de video a miles de millones de consumidores. Pasamos los últimos dos años enseñando a la IA a ver videos. Ahora, le estamos enseñando qué ignorar.
Lo que dice la gente

“We’re introducing a new capability to our latest Gemini models: agentic video understanding. This allows developers to process long-form video content with more accuracy, while using up to 88% less tokens. See how it works 🧵”

“introducing agentic video understanding with Gemini instead of using static processing (ingesting media at a fixed frame rate), the model can now take an active, goal-directed role in determining what to watch, at what speed, and through which modality (frames, audio, or”

“Meet Gemini Omni 1.1 Flash ⚡️ Our newest multimodal model for video generation and editing. It now features your favorite creative controls from Veo, plus brand new capabilities. Enjoy features like 4K upscaling, first / last frame control, and fast 360p drafting. But, the”
Passive vs Agentic Video AI
The Brief
Mantén la curiosidad
IA y tecnología: qué cambia y por qué importa.
Tu selección diaria, en inglés o español.
Gratis para siempre. Cancela cuando quieras.
Más historias



Conversación
Inicia la conversación