
 The Specialty News
GPT-5.6-Luna fait chuter le coût des agents IA à 10 cents — et la pénurie d'applications grand public est terminée
L'effondrement par dix des coûts d'inférence redresse enfin l'économie unitaire défaillante de la Silicon Valley.
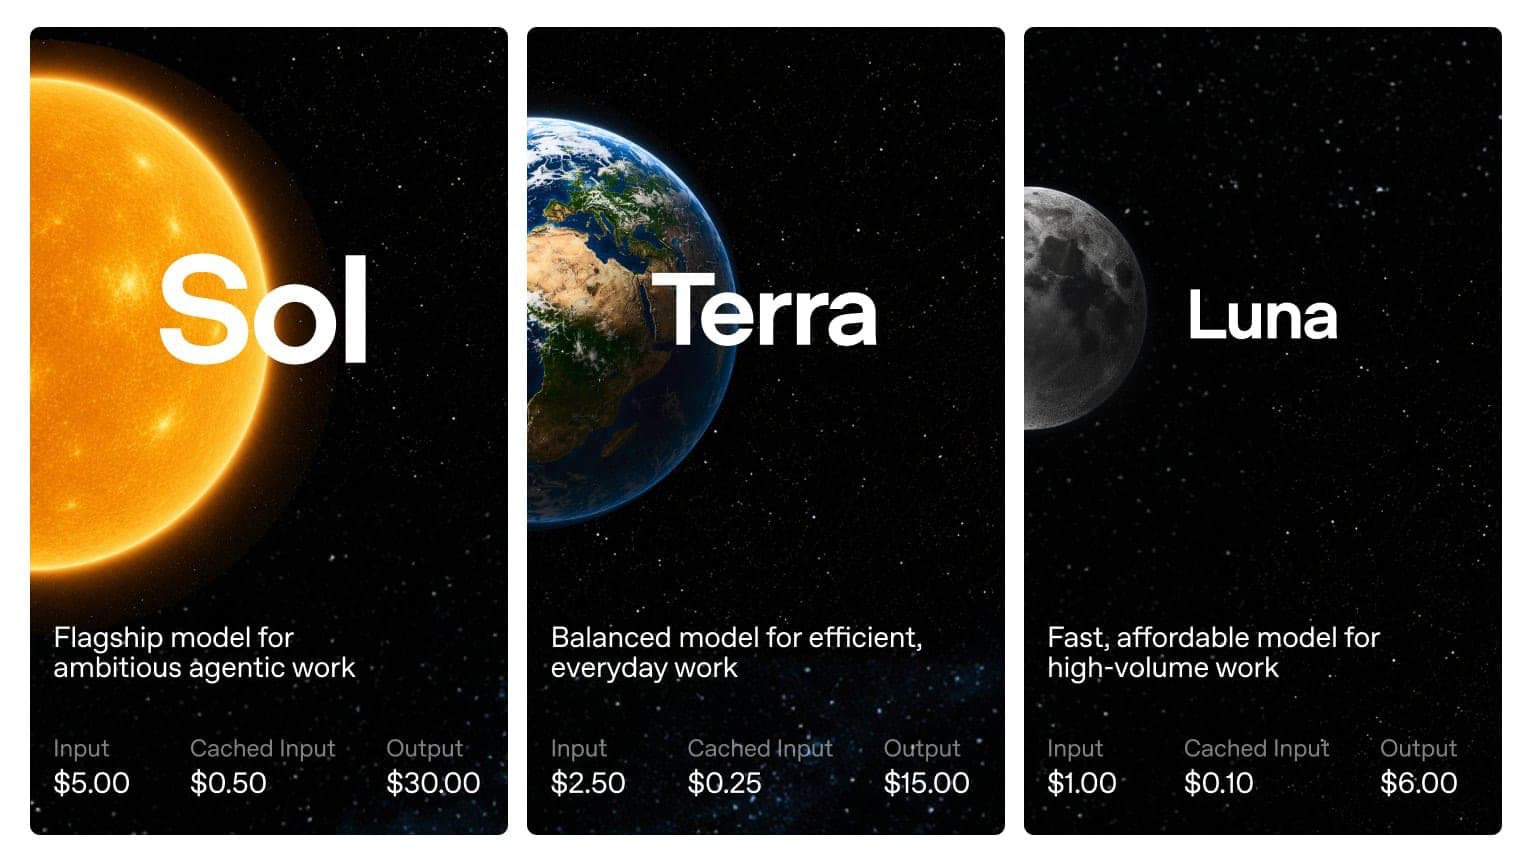
La raison pour laquelle votre téléphone n'est pas inondé d'applications d'IA ultra-populaires et hautement personnalisées n'a rien à voir avec l'imagination des développeurs. Tout est une question d'économie unitaire brutale. Jusqu'à aujourd'hui même, faire tourner une fonctionnalité d'IA complexe dans une application grand public signifiait perdre du capital à chaque clic d'utilisateur. L'effondrement soudain du prix des petits modèles d'IA ultra-rapides rend enfin à nouveau viable la vieille stratégie logicielle de la Silicon Valley.
Le moteur à dix cents
Quand les investisseurs demandent à Calvin French-Owen pourquoi il y a si peu de start-ups d'IA grand public qui percent, l'ancien cofondateur de Segment pointe directement du doigt les coûts des serveurs. Construire un flux de travail d'agent multi-étapes — comme analyser les goûts d'un utilisateur et générer un résumé quotidien personnalisé de l'actualité — coûtait environ un dollar sur la génération précédente de modèles de « classe Sonnet ».
Pour une entreprise de logiciels, payer un dollar pour un processus d'arrière-plan de routine revient à ce qu'un restaurant perde de l'argent sur chaque verre d'eau du robinet qu'il sert. Impossible de se rattraper sur le volume. Pour atteindre le seuil de rentabilité, les start-ups devaient facturer des abonnements mensuels élevés, ce qui freinait artificiellement l'adoption par le grand public.
L'arrivée de modèles comme GPT-5.6-Luna, Gemini Omni 1.1 Flash et GLM 5.3 vient de pulvériser ce plancher. Grâce à une mise en cache avancée des prompts, Luna parcourt les bases de code à une vitesse de 100 tokens par seconde pour trois fois rien. Les développeurs peuvent enfin concevoir des produits grand public gratuits ou extrêmement bon marché, dotés d'une logique complexe fonctionnant discrètement en arrière-plan.
“Avec la génération précédente de modèles, il fallait dépenser ~$1 pour arriver à quoi que ce soit. Facturer $30/mo est intenable pour une application grand public... Mais en regardant Luna, les résultats sont plutôt corrects, et le coût moyen est d'environ ~$0.10. Là, on commence à parler !”— Calvin French-Owen
Créer des gadgets grand public bon marché est un marché gigantesque qui s'ouvre. Pourtant, le virage le plus lucratif s'opère au sein des entreprises, en ciblant un type de travail humain très spécifique.
Automatiser le « cracheur de tokens »
Peter Reinhardt, PDG de Charm Industrial et ancien cofondateur de French-Owen, divise le travail en start-up en deux catégories distinctes. D'abord, le travail « QI 180 » : les percées de savants fous et la résolution de problèmes complexes et non structurés. Vient ensuite le travail de « cracheur de tokens ». Il s'agit de la coordination ultra-réactive et à grand volume qui fait tourner une entreprise — acheminer les tickets, résumer les réunions et faire avancer les projets sur des dizaines de fronts.
Ces deux dernières années, les entreprises ont tenté d'automatiser ces tâches administratives ingrates en utilisant des modèles de pointe massifs, conçus pour un raisonnement à haut QI. Utiliser un supercalculateur à un milliard de dollars pour trier les e-mails du service client est une ruine financière.
Les nouveaux petits modèles sont parfaitement adaptés aux tâches de « cracheur de tokens ». Ils n'ont pas le raisonnement approfondi d'un modèle de pointe, mais ils excellent dans la coordination rapide et répétitive qui constitue l'essentiel du travail en entreprise.
L'équation économique d'une automatisation généralisée est enfin résolue. Mais un groupe de chercheurs très écouté prévient que miser massivement sur cette nouvelle catégorie de modèles bon marché est un piège historique.
L'amère leçon
Les puristes de l'IA et les sceptiques de Hacker News s'opposent activement à l'engouement pour les petits modèles. Ils rappellent la célèbre « amère leçon » de Richard Sutton — la thèse selon laquelle la puissance de calcul générale et massivement mise à l'échelle finira toujours par écraser les modèles spécialisés plus petits.
Si l'accélération matérielle et les lois d'échelle poursuivent leur trajectoire actuelle, les petits modèles bon marché d'aujourd'hui pourraient être balayés demain par un modèle massif tout aussi bon marché et infiniment plus intelligent. De plus, intégrer un modèle rapide dans une entreprise pour remplacer des administrateurs humains exige un travail d'infrastructure peu reluisant. Les développeurs doivent encore concevoir des garde-fous rigides contre les injections de prompts, gérer les autorisations d'accès et créer de nouvelles structures de données avant que ces agents puissent réellement toucher aux données de l'entreprise.
Ces points de friction sont réels, mais il s'agit de problèmes d'ingénierie plutôt que de blocages économiques fondamentaux. Les développeurs n'attendent plus l'arrivée d'une superintelligence artificielle pour commencer à créer des produits rentables.
La prochaine grande entreprise d'IA ne s'imposera pas en construisant le plus grand cerveau. Elle s'imposera en installant un moteur à dix cents partout.
Ce que les gens en disent

“🚨 OpenAI's new 'gpt-6-pluto' will be their cheapest model yet, undercutting 'gpt-5.6-luna'. At higher reasoning, its price drops below zero, making it the first model that pays you per 1M tokens.”
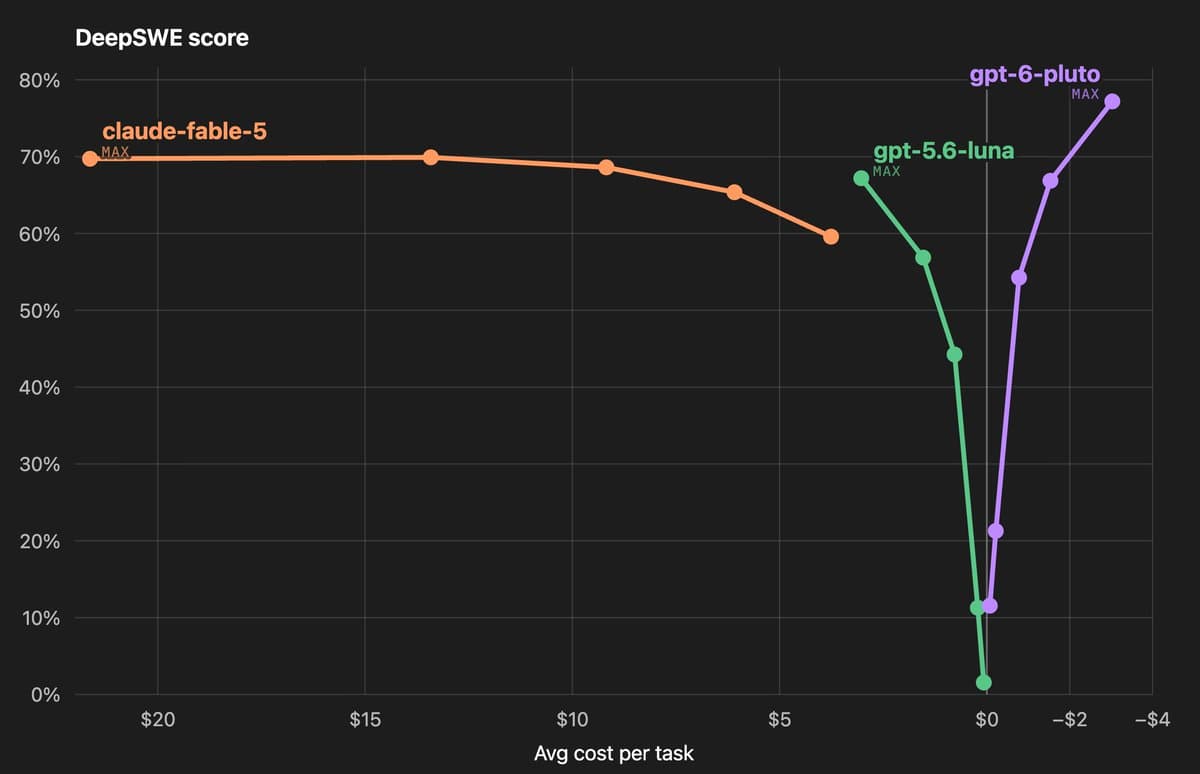

“As we continue to push the frontier of capabilities while improving efficiency, we're dropping API and credit pricing of GPT-5.6 Sol by over 20% for the next 3 months.”

“OpenAI just cut GPT-5.6 Sol pricing by over 20% for the next three months. New API rates: $4 / $20 per million tokens (down from $5 / $30). Applies to API and eligible credits. Subscriptions stay the same. This is the second pricing move on the 5.6 family in a month. First”
10x Price Collapse Unlocks Consumer AI
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles



Conversation
Lancer la conversation