
 The Specialty News
Cloudflare libère 100 téraoctets de RAM grâce à une modification de 533 octets — et expose un paradoxe de la Big Tech
Un ajustement microscopique du cache DNS de 1.1.1.1 a entraîné une hausse de vitesse de 19% et relancé un débat féroce sur l'optimisation prématurée
En supprimant un seul champ de capacité inutilisé d'une structure de données Rust, Cloudflare a instantanément récupéré 15 téraoctets de RAM. Cinq ajustements structurels subtils plus tard, ils ont réduit une seule entrée de cache DNS de 533 octets. À l'échelle planétaire, ces ajustements microscopiques se sont cumulés pour libérer une quantité de mémoire phénoménale dans le monde entier. Le logiciel est souvent considéré comme abstrait et immatériel, mais ce changement a prouvé exactement à quel point le code est lourd en réalité.
La géométrie du silicium
Le résolveur 1.1.1.1 de Cloudflare exploite une plateforme massive connue en interne sous le nom de Big Pineapple. Elle contient environ 250 milliards d'entrées de cache DNS actives à tout moment. Lorsqu'un ensemble de données est aussi massif, les commodités standard des langages de programmation de haut niveau deviennent un lourd passif financier.
L'ingénieur système Sebastiaan Neuteboom et son équipe ont commencé à traquer le remplissage (padding), les écarts d'alignement de mémoire et les décalages de pointeurs en Rust. Ils ont réalisé que les conteneurs de données standard réservent de la mémoire cachée pour pouvoir s'étendre plus tard. Or, les entrées de cache DNS sont entièrement immuables. En passant à des boîtes de taille exacte, en compressant les pointeurs de huit octets en décalages de deux octets et en regroupant les booléens dans des drapeaux binaires (bitflags), l'équipe a éliminé le gonflement structurel.
Les ingénieurs ont déployé discrètement les nouvelles structures de mémoire en mai 2026. En juillet, les tableaux de bord montraient une chute de la consommation de mémoire selon un profil parfait en escalier. L'équipe a libéré 100 téraoctets de mémoire, ce qui est exactement suffisant pour remplir entièrement les emplacements de RAM physique de 130 serveurs Gen 13 de Cloudflare. Pourtant, ce triomphe technique a immédiatement attiré une foule très sceptique.
Le piège de l'efficacité précoce
Lorsque Cloudflare a publié les détails techniques en août, l'article s'est hissé en tête de Hacker News. La question immédiate des critiques a été directe: pourquoi une entreprise d'infrastructure aussi massive utilisait-elle des structures de données génériques et volumineuses sur le chemin le plus sollicité d'Internet? Certains ingénieurs ont soutenu que l'équipe aurait dû utiliser des arènes de mémoire brute ou des allocateurs personnalisés dès le premier jour, plutôt que d'attendre huit ans pour corriger le tir.
Cette critique met en lumière une faille structurelle persistante dans le développement de logiciels en entreprise. Les ingénieurs sont rarement promus pour avoir conçu quelque chose de parfaitement efficace dès le départ. Ils sont promus, et acquièrent un statut de légende, pour avoir économisé des sommes massives en corrigeant des inefficacités des années plus tard, lorsque l'échelle commence à poser problème.
“Vous êtes récompensé pour faire un travail d'efficacité à la demande, pas de manière anticipée.”— scottlamb
Le camp pragmatique du «livrer d'abord» a immédiatement répliqué. Si Cloudflare avait conçu manuellement ces structures d'octets hyper-denses en 2018, la rigidité qui en aurait résulté aurait pu les empêcher d'ajouter de nouvelles fonctionnalités cruciales comme DNS-over-HTTPS ou le filtrage familial. Il faut survivre assez longtemps pour rencontrer un problème d'échelle avant de pouvoir le résoudre. Et le correctif lui-même a apporté un effet secondaire totalement inattendu.
Le paradoxe de la localité
L'informatique conventionnelle suggère que l'hyper-compression de la mémoire ralentit un système. Le processeur doit généralement consommer des cycles supplémentaires pour décompresser les données étroitement regroupées. Mais le Big Pineapple ne s'est pas ralenti.
Comme les structures de données étaient nettement plus petites, elles se logeaient beaucoup plus près les unes des autres dans le matériel. Ce regroupement serré a considérablement amélioré la localité de la mémoire, provoquant un pic des taux de réussite du cache du processeur. Le débit d'insertion a augmenté de 43% et la latence de recherche a chuté de 19%. Optimiser pour la mémoire s'est avéré être une optimisation pour la vitesse pure.
Cette nouvelle marge de manœuvre permet à Cloudflare de prendre en charge EDNS Client Subnet, une fonctionnalité qui exige que le cache stocke des milliers de variations régionales pour un seul domaine, le tout sans acheter de nouveau matériel. La leçon dépasse largement la programmation en Rust ou les protocoles DNS. À l'échelle planétaire, on cesse d'écrire du code pour commencer à gérer la géométrie physique du silicium.
Ce que les gens en disent

“errors are back down down to near zero after some more optimizations + allocating more resources thank you to the @Cloudflare team for jumping in and enabling that inference is a quirky workload with some unique challenges - post on that soon”
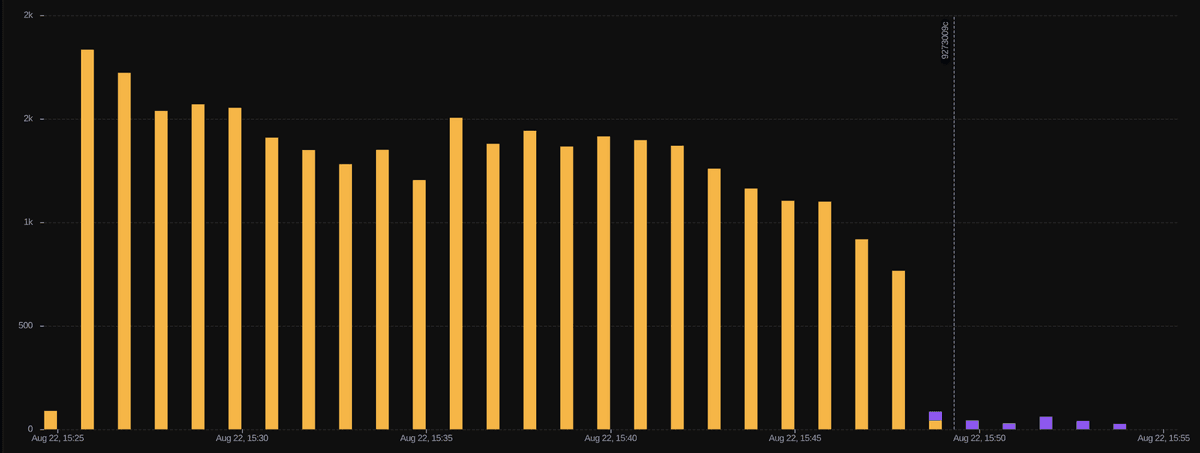

“We're now doing around 20,000 Omarchy ISO downloads PER DAY!! I'm oh so happy that we have @eastdakota on as a Founding Patron, and that we're serving from @Cloudflare's amazing CDN. Otherwise we'd be toast! That's well over 100TB/day. Just for ISO. Packages are extra.”

“OX Alpha is hosted in America!! 🇺🇸 I sent 49 identical one-token requests from 7 Cloudflare regions, rotated the order to control for load and matched every response to OpenRouter’s per-generation server timing. This isolated the geographic network floor: ATL: 57 ms DFW: 76 ms”
How 533 Bytes Freed 100TB
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles



Conversation
Lancer la conversation