
 The Specialty News
NVIDIA intègre les LPU de Groq pour dynamiser l'inférence IA de Vera Rubin
En séparant les tâches de prefill et de decode, la nouvelle plateforme Vera Rubin offre un débit 35 fois supérieur, redéfinissant ce qui est possible pour l'IA agentique.
Le principal obstacle à la prochaine génération d'IA n'est pas la puissance de calcul brute, c'est l'attente de la réponse. En dévoilant la plateforme Vera Rubin, NVIDIA a fait voler cette barrière en éclats en intégrant la technologie LPU de Groq, atteignant une hausse spectaculaire de 35x du débit d'inférence. Il ne s'agit pas d'une simple mise à jour matérielle incrémentale ; c'est un changement fondamental dans la manière de construire le cerveau des agents autonomes.
Le pouvoir de la division : prefill contre decode
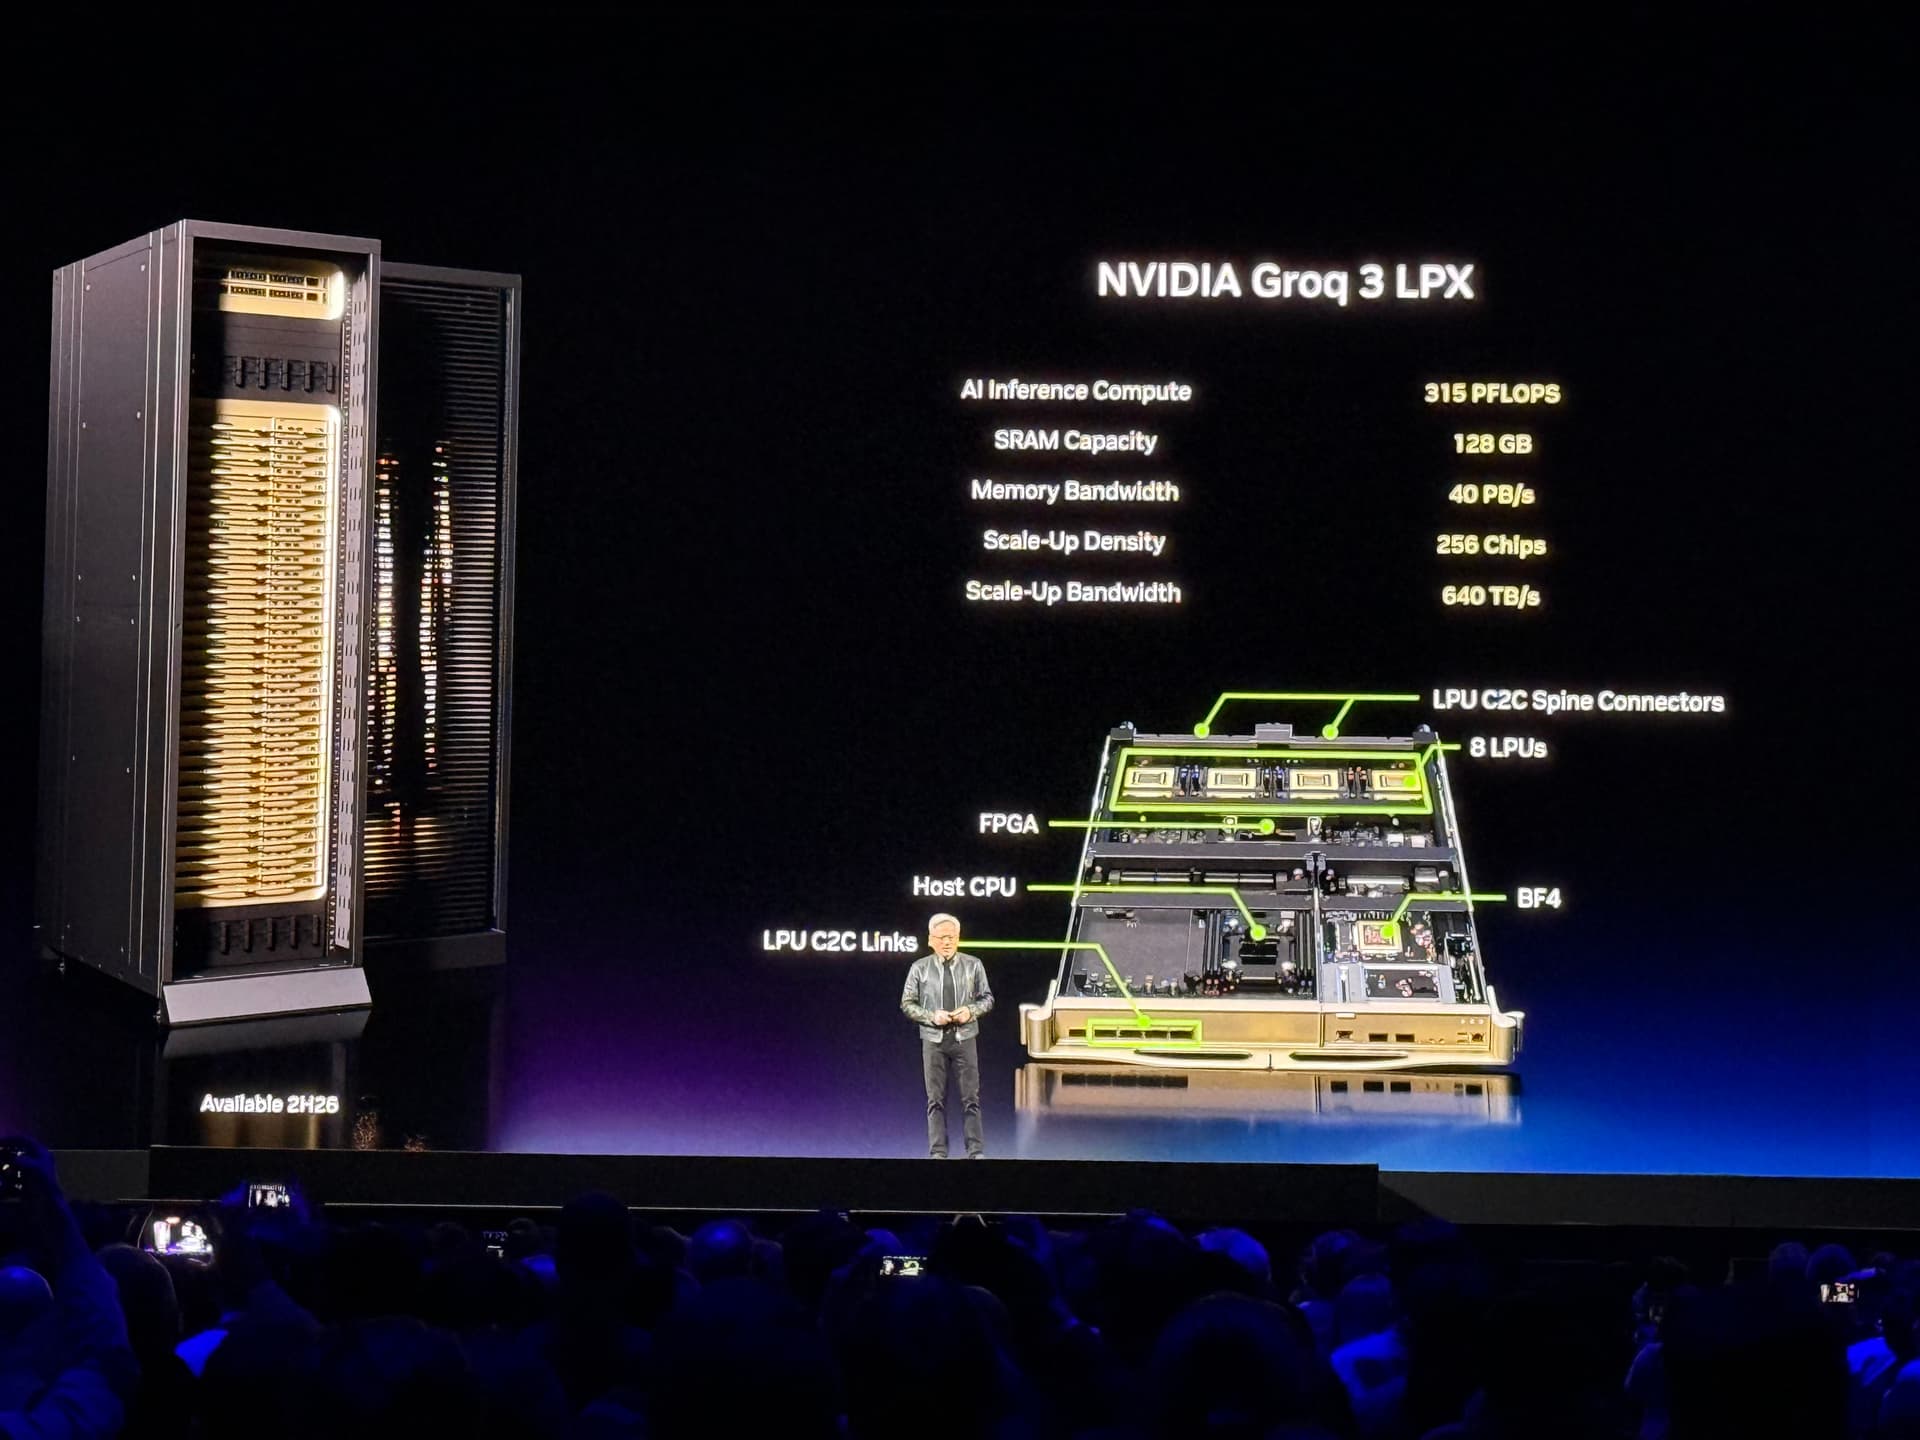
Historiquement, l'inférence IA était traitée comme une tâche monolithique, obligeant les GPU généralistes à assumer à la fois le gros du travail de traitement de l'entrée (prefill) et la génération séquentielle des tokens (decode). L'architecture Vera Rubin change la donne en scindant ces deux tâches. Le nouveau GPU Rubin, doté de mémoire HBM4 et capable de délivrer 50 petaFLOPS, prend en charge la phase de prefill, gourmande en mémoire. Une fois ce contexte établi, le relais est passé à la LPU Groq 3.
“ne demandez pas à une seule puce de tout faire ; laissez la bonne puce faire une seule chose à la perfection.”
La LPU de Groq est une reine de la latence. En renonçant à la mémoire externe au profit d'une immense SRAM embarquée, elle atteint 150 To/s de bande passante par puce, générant des tokens à une vitesse quasi instantanée. En répartissant ces tâches dans un rack LPX co-conçu, NVIDIA est parvenue à multiplier par 35 le débit d'inférence par mégawatt par rapport aux précédentes configurations Blackwell. C'est une leçon d'ingénierie classique : ne demandez pas à une seule puce de tout faire ; laissez la bonne puce faire une seule chose à la perfection.
Pourquoi l'IA agentique exige ce bond en avant
Nous passons actuellement des simples chatbots à l'IA agentique — des programmes autonomes qui exécutent des flux de travail en plusieurs étapes. Ces agents ne se contentent pas de produire du texte ; ils interagissent avec des API, analysent des fichiers et prennent des décisions en temps réel. Cela exige un niveau de réactivité que le matériel actuel ne peut tout simplement pas offrir sans entraîner des coûts énergétiques colossaux ou une latence exaspérante. Le mouvement stratégique de NVIDIA, avec une licence à 20 milliards de dollars pour la technologie de Groq, reconnaît que le « mur de la mémoire » est le dernier grand obstacle au passage à l'échelle de l'IA.
À l'avenir, cette approche hétérogène ouvre la voie à un bond massif dans l'adoption de l'IA en entreprise. Avec une disponibilité du matériel prévue pour fin 2026, on peut s'attendre à une vague d'applications d'IA jusque-là jugées trop lentes ou trop coûteuses. Pour les développeurs et les entreprises, le message est clair : l'ère de l'attente des tokens touche à sa fin, et celle des agents numériques autonomes ultra-rapides ne fait que commencer. Nous nous dirigeons vers un avenir où le calcul ne sera plus une contrainte, mais une simple ressource.
Divide and Accelerate
The Brief
Restez curieux
IA et technologie : ce qui change et pourquoi cela compte.
Votre sélection quotidienne, en anglais ou en espagnol.
Gratuit pour toujours. Désabonnement à tout moment.
Plus d'articles



Conversation
Lancer la conversation