
 The Specialty News
NVIDIA integra las LPU de Groq para disparar la inferencia de IA en Vera Rubin
Al dividir las tareas de prefill y decode, la nueva plataforma Vera Rubin ofrece un rendimiento 35 veces mayor, redefiniendo lo que es posible para la IA agéntica.
El mayor obstáculo para la próxima generación de IA no es la potencia de cálculo en bruto: es la espera de la respuesta. Con la presentación de la plataforma Vera Rubin, NVIDIA ha hecho añicos esa barrera al integrar la tecnología LPU de Groq, logrando un aumento asombroso del 35x en el rendimiento de inferencia. No se trata de una simple actualización de hardware; es un cambio fundamental en la forma de construir el cerebro de los agentes autónomos.
El poder de la división: prefill frente a decode
Históricamente, la inferencia de IA se trataba como una tarea monolítica, obligando a las GPU de propósito general a encargarse tanto del trabajo pesado de procesar la entrada (prefill) como de la generación secuencial de tokens (decode). La arquitectura Vera Rubin cambia las reglas del juego al dividir estas tareas. La nueva GPU Rubin, equipada con memoria HBM4 y capaz de ofrecer 50 petaFLOPS, se encarga de la fase de prefill, intensiva en memoria. Una vez fijado ese contexto, el testigo pasa a la LPU Groq 3.
“no hagas que un solo chip lo haga todo; haz que el chip adecuado haga una sola cosa a la perfección.”
La LPU de Groq es una maestra de la latencia. Al prescindir de la memoria externa en favor de una enorme SRAM integrada en el chip, alcanza 150 TB/s de ancho de banda por chip, generando tokens a velocidades que resultan prácticamente instantáneas. Al segregar estas tareas en un rack LPX co-diseñado, NVIDIA ha logrado exprimir 35 veces más rendimiento de inferencia por megavatio que en las anteriores configuraciones Blackwell. Es una lección clásica de ingeniería: no hagas que un solo chip lo haga todo; haz que el chip adecuado haga una sola cosa a la perfección.
Por qué la IA agéntica exige este salto
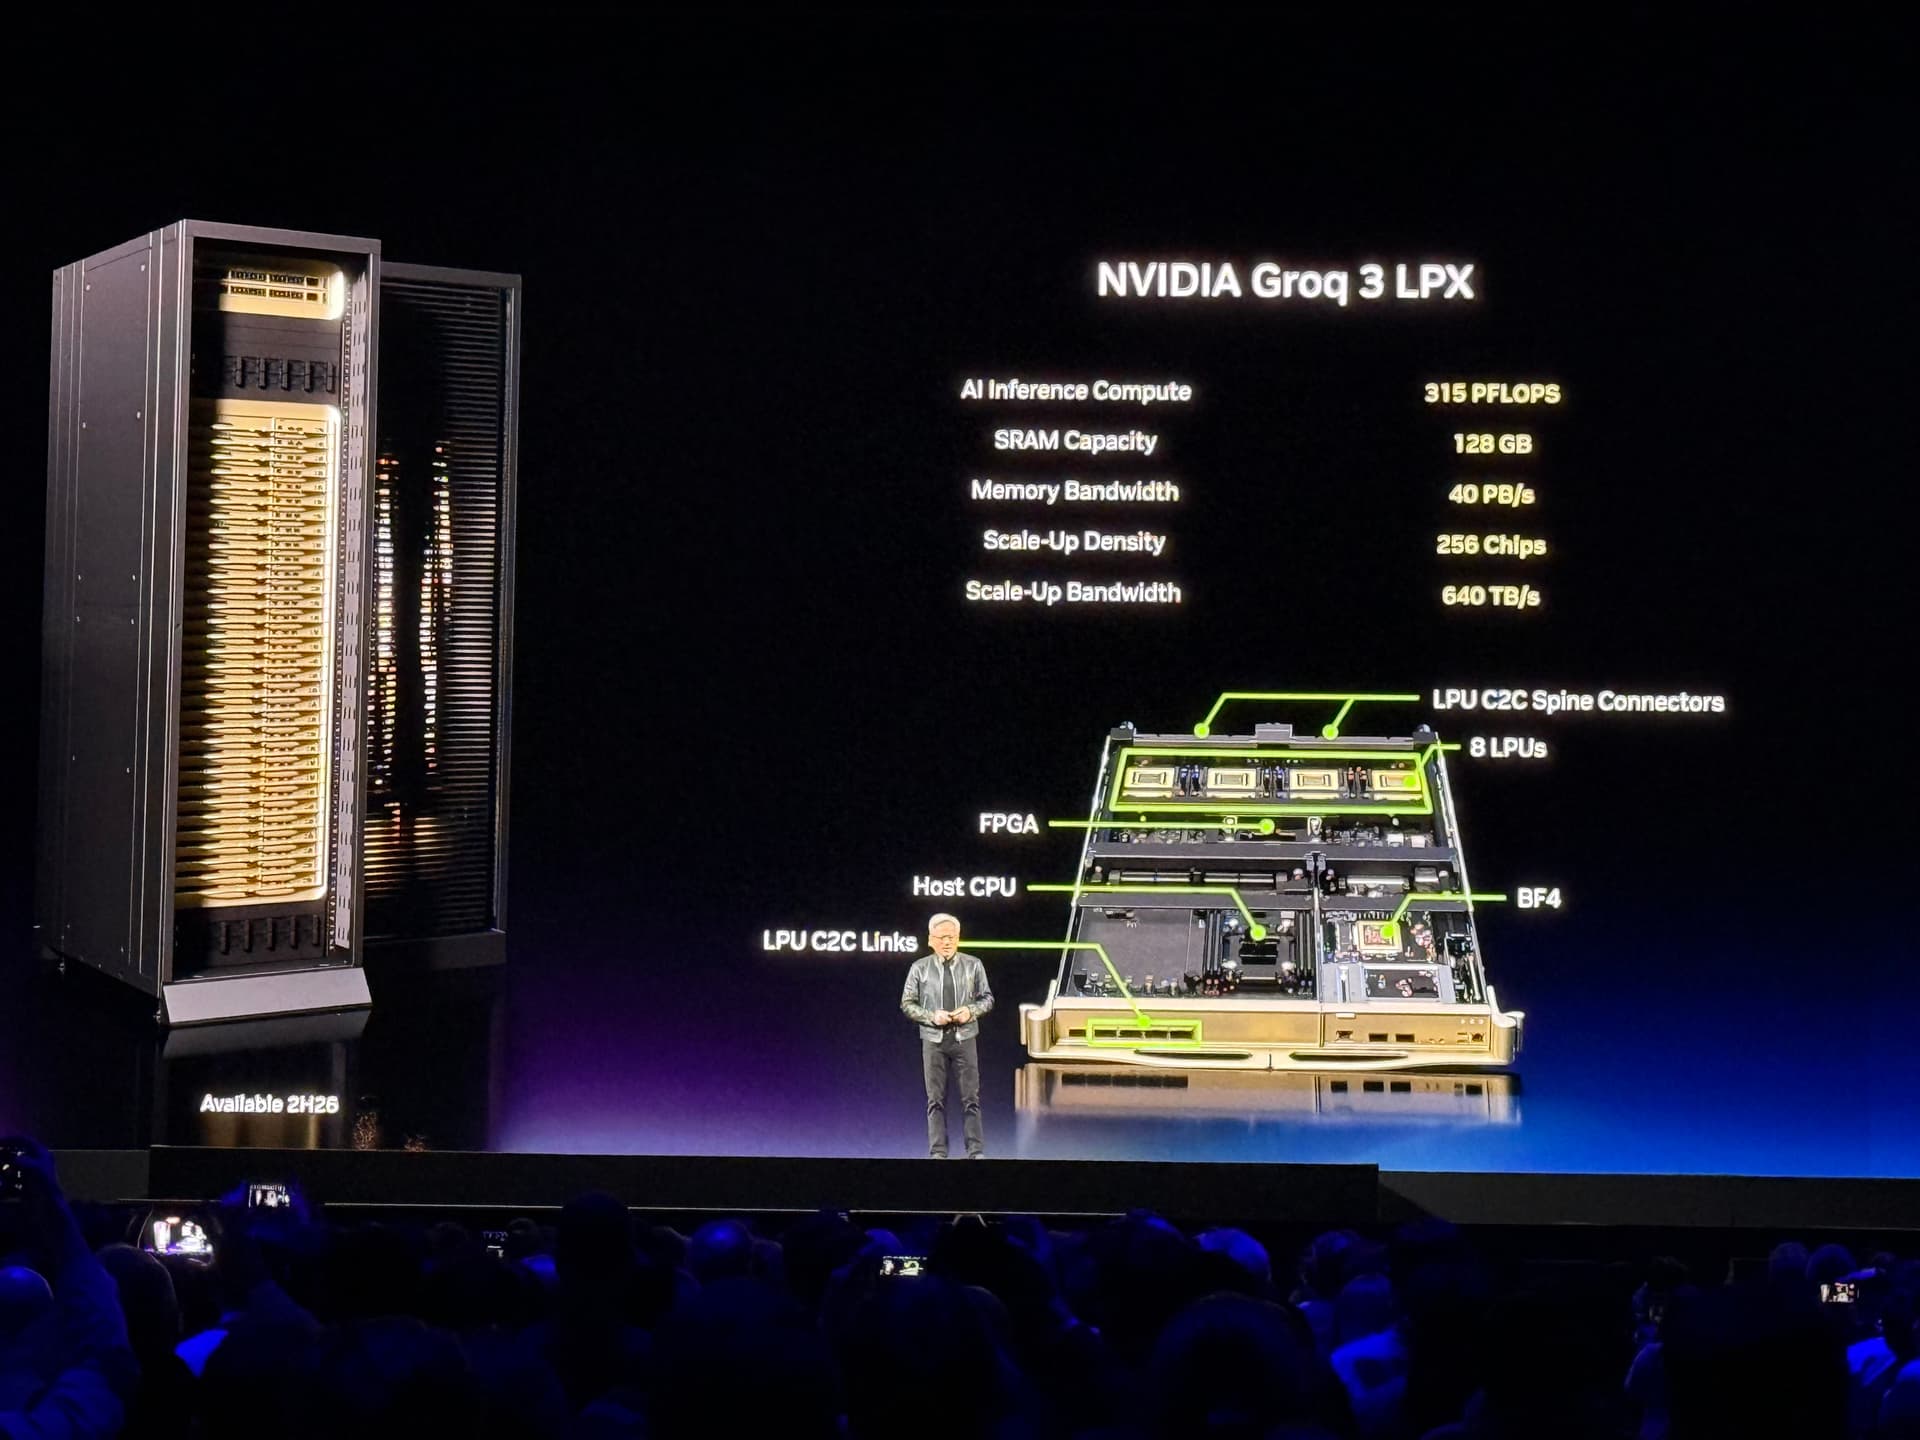
Estamos pasando de los simples chatbots a la IA agéntica: programas autónomos que ejecutan flujos de trabajo de varios pasos. Estos agentes no se limitan a generar texto; interactúan con API, analizan archivos y toman decisiones en tiempo real. Esto exige un nivel de capacidad de respuesta que el hardware actual sencillamente no puede ofrecer sin incurrir en costes energéticos desorbitados o en una latencia exasperante. El movimiento estratégico de NVIDIA, con una licencia de 20.000 millones de dólares para la tecnología de Groq, reconoce que el 'muro de la memoria' es el gran obstáculo final para escalar la IA.
De cara al futuro, este enfoque heterogéneo prepara el terreno para un salto masivo en la adopción de la IA empresarial. Con la disponibilidad del hardware prevista para finales de 2026, cabe esperar un auge de aplicaciones de IA que antes se descartaban por ser demasiado lentas o caras. Para desarrolladores y empresas, la conclusión es clara: la era de esperar a que aparezcan los tokens está terminando, y la era de los agentes digitales autónomos de alta velocidad apenas comienza. Nos dirigimos hacia un futuro en el que la computación deja de ser una limitación para convertirse en una materia prima más.
Divide and Accelerate
The Brief
Mantén la curiosidad
IA y tecnología: qué cambia y por qué importa.
Tu selección diaria, en inglés o español.
Gratis para siempre. Cancela cuando quieras.
Más historias



Conversación
Inicia la conversación