
 The Specialty News
GPT-5.6-Luna reduce el coste de los agentes de IA a 10 centavos y pone fin a la sequía de aplicaciones de consumo
Un desplome de 10 veces en los precios de inferencia finalmente ha solucionado la rota economía unitaria de Silicon Valley.
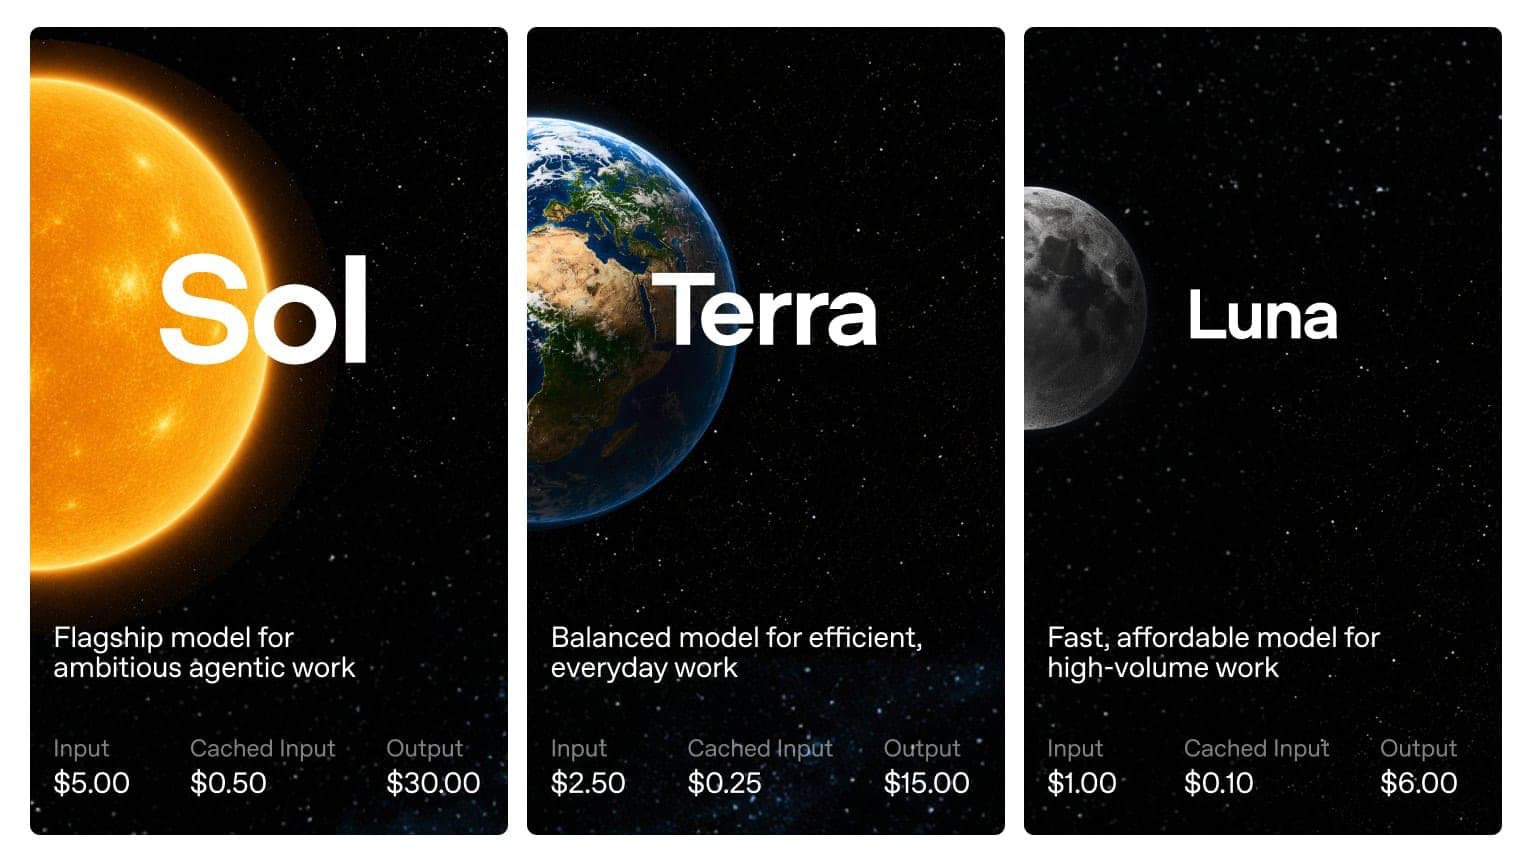
La razón por la que tu teléfono no está inundado de aplicaciones de IA sumamente populares y altamente personalizadas no tiene nada que ver con la imaginación de los desarrolladores. Se reduce a una brutal economía unitaria. Hasta este preciso momento, ejecutar una función de IA compleja en una aplicación de consumo masivo significaba perder capital con cada clic del usuario. Un desplome repentino en el precio de los modelos de IA pequeños e hiperrápidos finalmente ha hecho que el viejo manual de software de Silicon Valley vuelva a ser viable.
El motor de diez centavos
Cuando inversores le preguntan a Calvin French-Owen por qué hay tan pocas empresas emergentes de IA de consumo que destaquen, el cofundador de Segment señala directamente a los costes de los servidores. Crear un flujo de trabajo de agente de varios pasos —como investigar los gustos de un usuario y generar un resumen de noticias diario personalizado— costaba aproximadamente un dólar en la generación anterior de modelos de "clase Sonnet".
Que una empresa de software pague un dólar por un proceso rutinario en segundo plano es como si un restaurante perdiera dinero con cada vaso de agua del grifo que sirve. Nunca podrán compensarlo con el volumen. Para alcanzar el punto de equilibrio, las empresas emergentes tenían que cobrar elevadas tarifas de suscripción mensual, lo que asfixiaba artificialmente la adopción masiva.
La llegada de modelos como GPT-5.6-Luna, Gemini Omni 1.1 Flash y GLM 5.3 acaba de romper ese suelo. Con un almacenamiento en caché de prompts avanzado, Luna procesa bases de código a 100 tokens por segundo por unos pocos centavos. Los desarrolladores finalmente pueden crear productos de consumo gratuitos o extremadamente baratos con una lógica compleja ejecutándose silenciosamente en segundo plano.
“Con la generación anterior de modelos, te gastabas alrededor de $1 para llegar a cualquier parte. Cobrar $30 al mes es insostenible para una aplicación de consumo... Pero al mirar a luna, los resultados son bastante decentes y el coste promedio es de unos ~$0.10. ¡Ahora sí que estamos hablando!”— Calvin French-Owen
Crear juguetes de consumo baratos es un mercado masivo por explotar. Sin embargo, el cambio más lucrativo se está produciendo dentro de las empresas, apuntando a un tipo muy específico de trabajo humano.
Automatizar el generador de tokens
Peter Reinhardt, CEO de Charm Industrial y antiguo cofundador de French-Owen, divide el trabajo en las empresas emergentes en dos categorías distintas. Primero está el trabajo de "CI 180": avances de científico loco y resolución de problemas profunda y no estructurada. Luego viene el trabajo de "generador de tokens". Esta es la coordinación de alto volumen y respuesta ultrarrápida que mantiene a una empresa en funcionamiento: dirigir tickets de soporte, resumir reuniones y dar impulso a los proyectos en docenas de frentes.
Durante los últimos dos años, las empresas intentaron automatizar este trabajo administrativo rutinario utilizando modelos de frontera masivos diseñados para un razonamiento de alto CI. Utilizar un superordenador de mil millones de dólares para clasificar correos electrónicos de atención al cliente es la ruina financiera.
Los nuevos modelos pequeños se adaptan perfectamente a los trabajos de "generador de tokens". Carecen del razonamiento profundo de un modelo de frontera, pero destacan en la coordinación rápida y repetitiva que constituye la mayor parte del trabajo corporativo.
Las cuentas para una automatización generalizada finalmente cuadran. Pero un grupo ruidoso de investigadores advierte que apostar fuertemente por este nuevo nivel de modelos baratos es una trampa histórica.
La amarga lección
Los puristas de la IA y los escépticos de Hacker News rechazan activamente el entusiasmo por los modelos pequeños. Señalan la famosa "Amarga lección" de Richard Sutton, la tesis de que la computación general a escala masiva siempre terminará por aplastar a los modelos más pequeños y especializados.
Si la aceleración de hardware y las leyes de escala continúan su trayectoria actual, los modelos pequeños y baratos de hoy podrían verse barridos mañana por un modelo masivo igualmente barato e infinitamente más inteligente. Además, integrar un modelo rápido en una empresa para reemplazar a los administradores humanos requiere un trabajo de infraestructura poco glamuroso. Los desarrolladores todavía tienen que construir redes de seguridad rígidas contra la inyección de prompts, permisos de acceso y nuevos arneses de datos antes de que estos agentes puedan realmente tocar los datos corporativos.
Esos puntos de fricción son reales, pero son problemas de ingeniería más que obstáculos económicos fundamentales. Los desarrolladores ya no están esperando a que llegue la superinteligencia artificial para empezar a crear productos rentables.
La próxima gran empresa de IA no ganará construyendo el cerebro más grande. Ganará colocando un motor de diez centavos en todas partes.
Lo que dice la gente

“🚨 OpenAI's new 'gpt-6-pluto' will be their cheapest model yet, undercutting 'gpt-5.6-luna'. At higher reasoning, its price drops below zero, making it the first model that pays you per 1M tokens.”
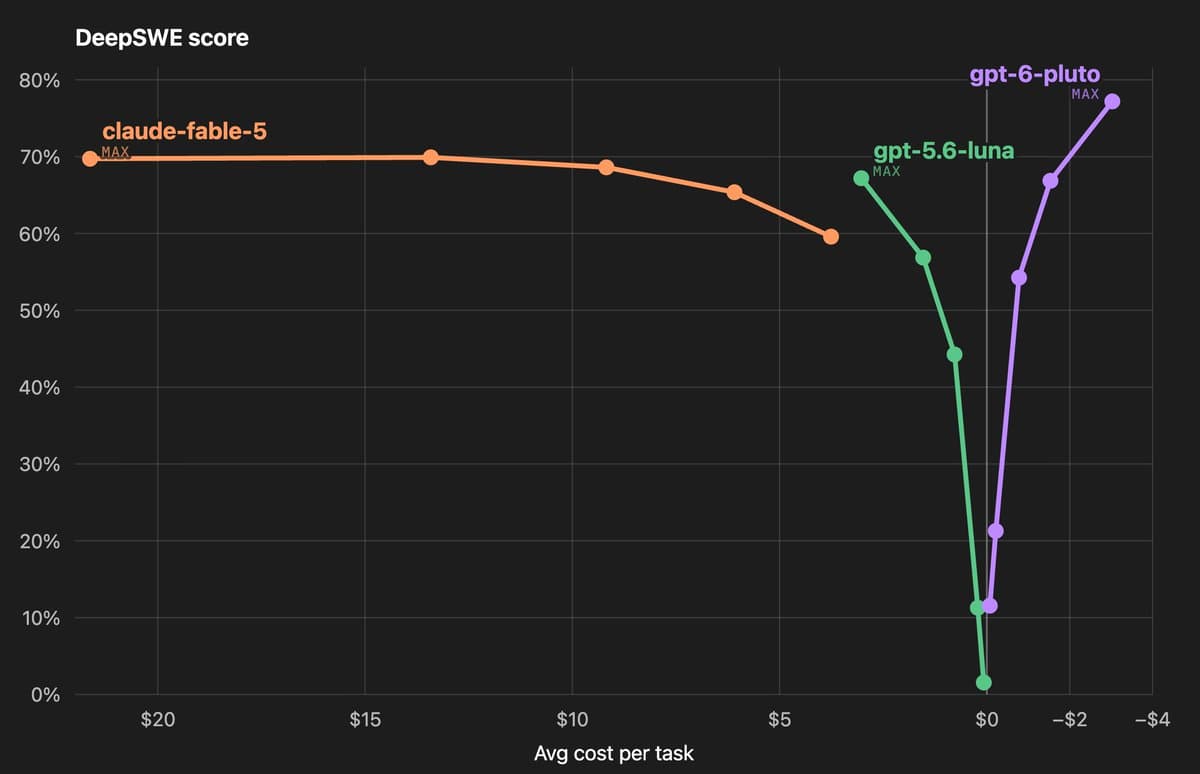

“As we continue to push the frontier of capabilities while improving efficiency, we're dropping API and credit pricing of GPT-5.6 Sol by over 20% for the next 3 months.”

“OpenAI just cut GPT-5.6 Sol pricing by over 20% for the next three months. New API rates: $4 / $20 per million tokens (down from $5 / $30). Applies to API and eligible credits. Subscriptions stay the same. This is the second pricing move on the 5.6 family in a month. First”
10x Price Collapse Unlocks Consumer AI
The Brief
Mantén la curiosidad
IA y tecnología: qué cambia y por qué importa.
Tu selección diaria, en inglés o español.
Gratis para siempre. Cancela cuando quieras.
Más historias



Conversación
Inicia la conversación