
 The Specialty News
GPT-5.4 CODEX lidera el sector en razonamiento arquitectónico profundo
Con una puntuación del 35.48% en la brutal prueba de rendimiento SWE Atlas, GPT-5.4 CODEX revela una enorme brecha entre la programación y el verdadero pensamiento de sistemas.
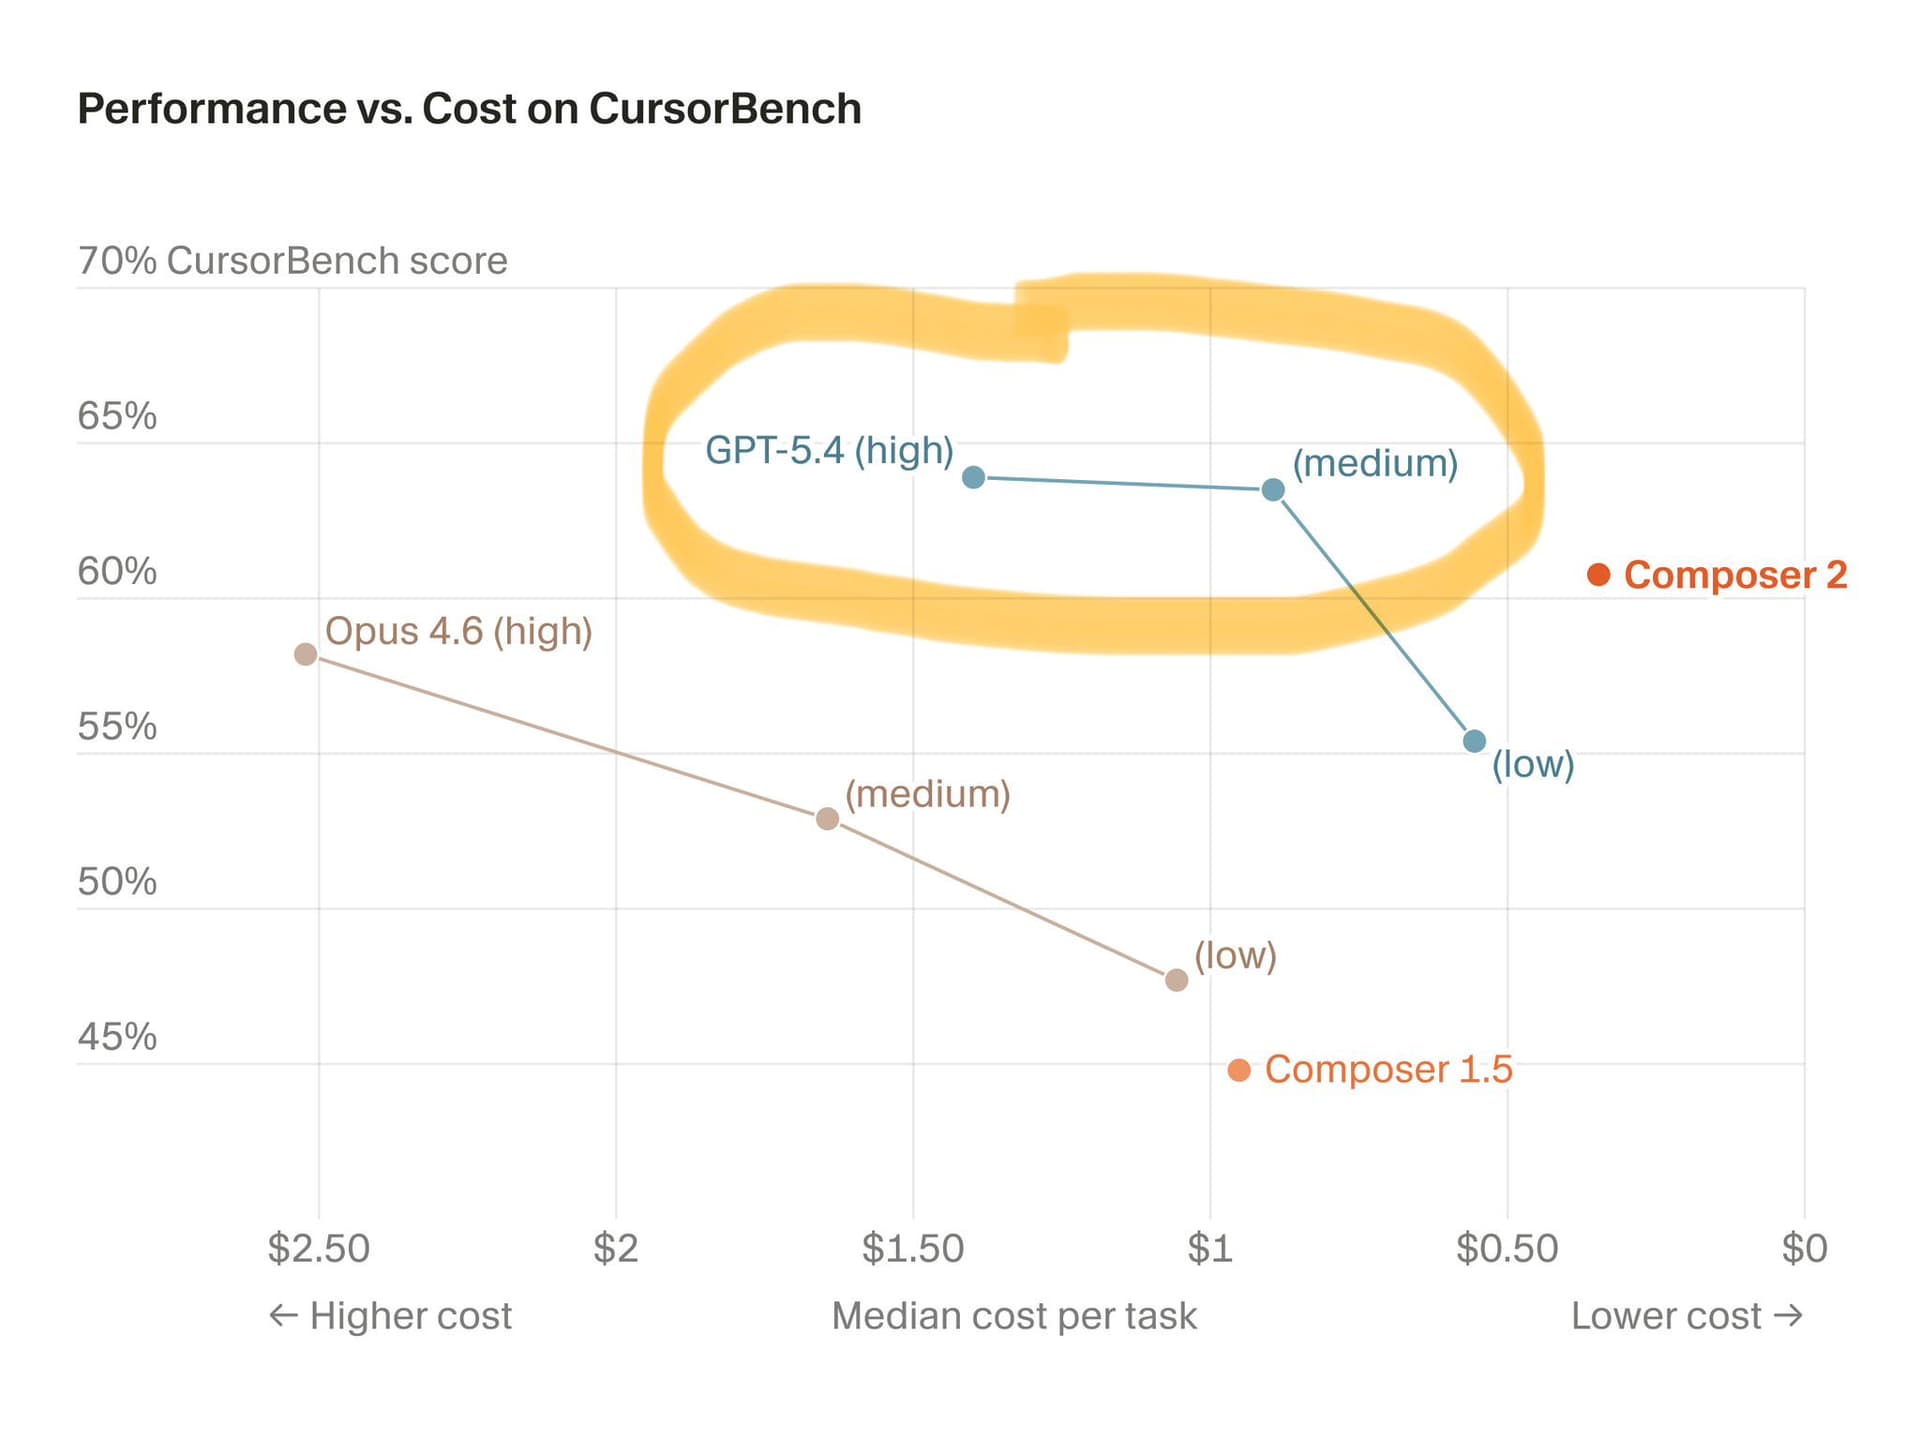
El listón de la ingeniería de software con IA acaba de subir, y está significativamente más alto de lo que la mayoría cree. Mientras que los modelos de frontera han estado presumiendo de tasas de éxito del 80% en tareas de programación estándar, GPT-5.4 CODEX (xHigh) acaba de establecer un nuevo estándar en la prueba de rendimiento SWE Atlas, mucho más difícil, con una puntuación de precisión del 35.48%. Este rendimiento destaca una transición crítica: del simple parcheo de código a la desalentadora tarea de comprender una arquitectura de sistemas compleja y de múltiples archivos.
Más allá del parche táctico
Durante meses, la industria ha estado obsesionada con SWE-Bench Pro, que evalúa si una IA puede actuar como un desarrollador júnior: localizando un error y escribiendo una corrección quirúrgica dentro de un archivo específico. Pero como señaló el investigador @chatgpt21, esta destreza táctica es engañosa. El verdadero cuello de botella para la IA en entornos de producción no es solo corregir un error de escritura; es navegar por la naturaleza laberíntica de la arquitectura de software moderna, donde un solo cambio puede desencadenar un fallo en cadena en cualquier otra parte.
Por eso SWE Atlas es el nuevo 'jefe final' para los modelos. Obliga a una IA a explorar un repositorio en un entorno de prueba, realizar experimentos y llevar a cabo un análisis profundo en múltiples archivos interconectados para responder a preguntas arquitectónicas de alto nivel. En este ámbito, los mejores modelos no están alcanzando el 80%; están luchando por superar la barrera del 35%. La capacidad de GPT-5.4 CODEX para superar a Claude-Opus 4.6 en este terreno demuestra que la carrera por la 'ingeniería autónoma' está pasando del reconocimiento de patrones al razonamiento real.
El futuro estratégico de la programación
Piensa en este cambio como la evolución de los motores de ajedrez. Las primeras pruebas de rendimiento de IA eran como problemas tácticos: encontrar la mejor jugada en un escenario estático. SWE Atlas equivale a exigir a un motor que juegue una partida posicional completa, evaluando la salud a largo plazo de todo el ecosistema de software en lugar de limitarse a la siguiente jugada. Esta es la diferencia entre una IA que funciona como un autocompletado sofisticado y una que actúa como un verdadero socio de ingeniería.
“Esta es la diferencia entre una IA que funciona como un autocompletado sofisticado y una que actúa como un verdadero socio de ingeniería.”
De cara al futuro, esta enorme brecha de rendimiento —del 80% en tareas tácticas al 35% en las arquitectónicas— define la próxima frontera del desarrollo de la IA. Si queremos que la IA llegue a gestionar proyectos de software de largo alcance, los laboratorios deben ir más allá del simple escalado de parámetros. Necesitamos modelos que demuestren una mejor recuperación de errores y una planificación iterativa. Los modelos que resuelvan esto no solo serán más rápidos; serán los primeros verdaderamente capaces de construir y mantener nuestra infraestructura digital más compleja.
Patching Bugs vs Systems Thinking
The Brief
Mantén la curiosidad
IA y tecnología: qué cambia y por qué importa.
Tu selección diaria, en inglés o español.
Gratis para siempre. Cancela cuando quieras.
Más historias





Conversación
Inicia la conversación