
 The Specialty News
Por qué los agentes de IA del mañana necesitan una forma mejor de recordar
La IA de larga duración está chocando con un muro de contexto, y la solución se parece menos al entrenamiento y más a la memoria humana

Vivimos actualmente en la era del 'truco de prompt'. Para que los agentes de IA gestionen tareas complejas y de larga duración, los obligamos a jugar a un juego constante de resúmenes y delegación de subtareas, engañándolos en esencia para que recuerden borrando su pizarra una y otra vez. Aunque eficaz, este enfoque está tocando techo, lo que ha abierto un debate de fondo entre investigadores sobre cómo deberíamos gestionar realmente la memoria a largo plazo de una IA.
El fracaso del reentrenamiento constante
Awni Hannun, investigador principal y cocreador del framework MLX, señaló recientemente los fallos de nuestra obsesión actual con el ajuste fino en línea. Cuando intentamos actualizar el conocimiento de un modelo de IA en tiempo real mientras interactúa con el mundo, topamos con un problema clásico: el olvido catastrófico. Al aprender información nueva, el modelo sobrescribe o corrompe sin querer el conocimiento que ya poseía, cambiando en esencia su pasado por un presente que podría ser, en conjunto, menos capaz.
Más allá de la inestabilidad, la pesadilla de ingeniería es enorme. Generar datos de entrenamiento de alta calidad sobre la marcha —y encontrar después la forma de equilibrar esa información nueva con los datos antiguos sin romper toda la estructura— es una tarea de una complejidad inmensa. Hannun y otros en el campo están cada vez más convencidos de que no hace falta obligar al modelo a 'aprender' todo de forma permanente en sus pesos centrales. En su lugar, necesitamos una forma mejor de almacenar y recuperar la información que ve.
Construir una memoria inspirada en el ser humano
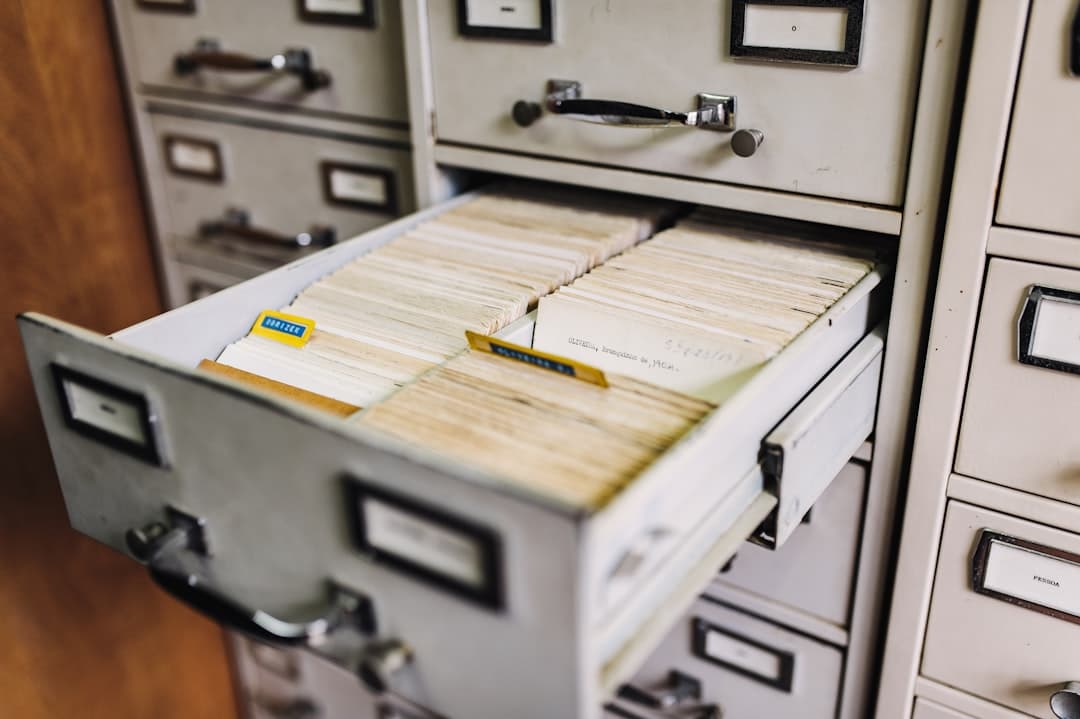
El camino a seguir se parece menos a un trasplante de cerebro digital y más a un sistema de archivo de oficina bien organizado. Hannun propone un giro hacia técnicas basadas en la memoria que traten la memoria de la IA tal y como lo hace el cerebro humano: mediante retención selectiva y descarte inteligente. Si un agente puede identificar qué información resulta realmente útil —reteniendo lo que consulta con frecuencia y desprendiéndose del ruido cuando ya no lo necesita—, puede mantener la continuidad sin volverse pesado ni confuso.
“El futuro no consiste en dar a los agentes más potencia bruta, sino en darles la capacidad de recordar exactamente lo que necesitan, exactamente cuando lo necesitan.”
Aquí es donde las estructuras jerárquicas se convierten en el estándar de oro. De forma parecida a la transición informática que nos dio los sistemas de archivos organizados, estamos entrando en una fase en la que los agentes de IA pasarán de ventanas de contexto 'planas' a bases de datos jerárquicas y consultables. Tecnologías como el ajuste fino de memoria dispersa, que actualiza solo fragmentos pequeños de un modelo, ya están demostrando que podemos conservar el rendimiento a largo plazo sin el desorden de actualizar todos los pesos. El futuro no consiste en dar a los agentes más potencia bruta, sino en darles la capacidad de recordar exactamente lo que necesitan, exactamente cuando lo necesitan.
Two Ways to Remember
The Brief
Mantén la curiosidad
IA y tecnología: qué cambia y por qué importa.
Tu selección diaria, en inglés o español.
Gratis para siempre. Cancela cuando quieras.
Más historias




Conversación
Inicia la conversación